La noticia en una frase
AWS ha abierto en beta pública TorchNeuron, un backend nativo de PyTorch que permite ejecutar código de IA en sus aceleradores Trainium con cambios mucho menores que los exigidos por una integración de hardware separada. La novedad no elimina la ingeniería de migración, pero reduce el coste inicial de probar una alternativa al acelerador habitual.
El cambio: de adaptar el modelo a cambiar el dispositivo
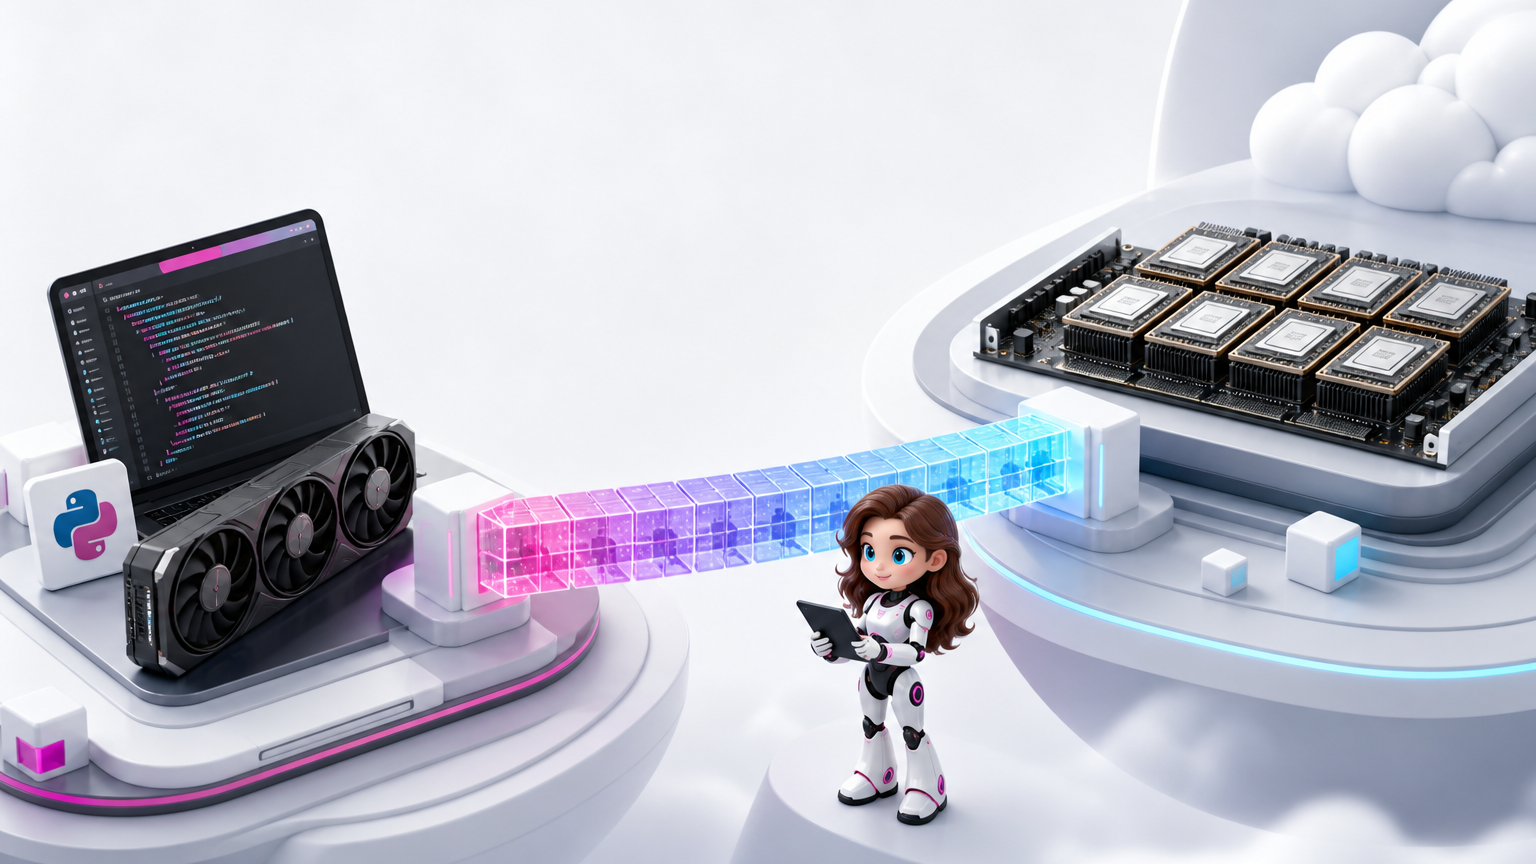
El anuncio de AWS, publicado el 20 de octubre de 2026, presenta TorchNeuron como un proyecto de código abierto para Trainium2 y Trainium3. La propuesta es concreta: un modelo que ya usa PyTorch puede mover sus tensores al dispositivo neuron en lugar de cuda, conservar las APIs habituales y trabajar en modo eager o mediante torch.compile.
La documentación de AWS describe también soporte para APIs distribuidas de PyTorch, como DDP, FSDP2, DTensor y paralelismo tensorial. El proyecto se integra con el Neuron Kernel Interface (NKI) para quienes necesiten escribir operadores personalizados y exprimir una operación concreta del hardware. PyTorch indica que el backend se publica bajo licencia Apache 2.0.
Eso importa porque la barrera para cambiar de acelerador rara vez es solo comprar o alquilar el chip. El problema está en todo lo que lo rodea: el código de entrenamiento, los cargadores de modelos, los compiladores, la distribución, los checkpoints, las métricas y los casos límite que aparecen después de miles de pasos.
La lectura Olbrite: la portabilidad se convierte en una ventaja competitiva
Durante años, una parte del valor de los aceleradores se ha construido alrededor de su ecosistema de software. Cuando cada plataforma exige una ruta propia, el equipo termina optimizando no solo el modelo, sino también una dependencia tecnológica. TorchNeuron ataca ese punto de fricción desde el lado del framework más usado por los equipos de investigación y producto.
La tesis es sencilla: si probar otro acelerador se parece más a cambiar el dispositivo que a reescribir la aplicación, la decisión de infraestructura vuelve a medirse con datos. Rendimiento, disponibilidad, consumo, tiempo de compilación y coste total pasan a pesar más que el miedo a quedar atrapado en una integración.
No significa que Trainium se vuelva equivalente a cualquier GPU ni que una línea de código garantice una migración sin trabajo. Significa que AWS está intentando convertir la elección de hardware en una decisión más reversible. Para una empresa, esa reversibilidad tiene valor propio: permite comparar antes de comprometer capacidad, presupuesto y arquitectura.
Qué hay realmente detrás de la promesa
La publicación de PyTorch distingue tres caminos de trabajo:
- Eager execution, útil para investigación, depuración y ciclos de prueba rápidos.
torch.compile, que captura y optimiza gráficos para cargas más estables y orientadas a producción.- NKI, para operadores y ajustes específicos cuando las abstracciones estándar no bastan.
Amazon Science añade una pieza menos visible pero decisiva. Para ajustar y evaluar TorchNeuron, sus equipos usaron agentes de IA para reducir cientos de miles de modelos de Hugging Face a 841 modelos representativos y extraer formas tensoriales relevantes. También describen cachés y compilación compartida que redujeron aproximadamente en un tercio el tiempo hasta el primer paso de entrenamiento en una prueba con un modelo de lenguaje distribuido entre aceleradores. Es un resultado de esa evaluación, no una garantía universal para cualquier modelo.
La diferencia práctica está en esa última frase. La portabilidad del código abre la puerta; la validación del workload decide si conviene cruzarla.
El impacto empresarial en seis frentes
1. Operaciones
Los equipos pueden diseñar una prueba A/B de infraestructura sin crear desde cero una segunda implementación del entrenamiento. Eso acorta el camino entre “hay una alternativa” y “tenemos una cifra comparable”.
2. Costes
El coste relevante no es únicamente el precio por hora del acelerador. Hay que sumar compilación, tiempo de ingeniería, capacidad ociosa, reintentos, observabilidad y coste de migrar cuando cambia el modelo. Si TorchNeuron reduce el trabajo específico de plataforma, la comparación económica se vuelve más honesta; si introduce compilaciones lentas o incompatibilidades, ese ahorro desaparece.
3. Producto
Una arquitectura menos atada a un único dispositivo da más margen para responder a picos de demanda, regiones con distinta disponibilidad o cambios de proveedor. La flexibilidad no es una promesa de rendimiento: es una opción para decidir con menos bloqueo.
4. Personas y talento
Un ingeniero que ya domina PyTorch puede empezar con APIs conocidas. Eso no reemplaza el conocimiento de Trainium, pero reduce la necesidad de mantener una especialización aislada para cada fase del ciclo de vida.
5. Riesgo técnico
La beta pública obliga a probar compatibilidad real. Hay que revisar operaciones no soportadas, fallback a CPU, formas dinámicas, precisión, checkpoints, paralelismo, observabilidad y diferencias numéricas. La simplificación del camino de entrada no elimina la responsabilidad de verificar el resultado.
6. Estrategia
La señal más importante no es “AWS tiene otro chip”. Es que el proveedor intenta hacer que cambiar de chip sea menos traumático. Si esa dirección se consolida, el poder de negociación de los equipos de IA aumenta: pueden pedir evidencia de rendimiento en lugar de aceptar una plataforma por inercia.
Qué hacer esta semana si tu empresa entrena o sirve modelos
- Inventaria la dependencia actual. Busca llamadas CUDA específicas, extensiones personalizadas, supuestos sobre memoria, kernels propios y pasos de compilación que no formen parte de PyTorch estándar.
- Elige un workload representativo. Usa un modelo, dataset, longitud de secuencia y configuración que reflejen producción; no un ejemplo diminuto elegido para que todo pase.
- Mide antes de migrar. Registra calidad, tiempo hasta el primer paso, throughput sostenido, memoria, coste por experimento y tiempo de depuración.
- Prueba el ciclo completo. Incluye carga de checkpoints, reanudación, entrenamiento distribuido, inferencia, logging y recuperación ante fallos. Un modelo que arranca no es todavía una plataforma operativa.
- Define una puerta de salida. Mantén la ruta existente hasta que la beta demuestre paridad suficiente y documenta qué operaciones o versiones impiden cambiar de proveedor.
Lo que todavía hay que observar
TorchNeuron está en beta pública y su matriz de soporte importa tanto como su API. Las notas de la versión 2.33.0 indican que las ruedas precompiladas de esta entrega se orientan a Ubuntu 26.04, mientras que el soporte de ruedas para Ubuntu 22.04 y 24.04 queda para una entrega posterior; en esos entornos, el equipo debe revisar la ruta de instalación y compilación. También conviene seguir la cobertura de modelos, la estabilidad de torch.compile, la experiencia distribuida y la disponibilidad efectiva de Trainium2 y Trainium3 en las regiones necesarias.
La pregunta empresarial no es si el código “corre”. Es si corre con la calidad, el rendimiento, la observabilidad y el coste que el negocio necesita.
La conversación continúa en Olbrite
El movimiento de software de AWS llega mientras la infraestructura física de la IA gana peso. En “La IA física empieza en el silicio” explicamos por qué sensores, memoria y cómputo empiezan a diseñarse como un sistema; y en “La IA puede tener modelos de sobra y aun así quedarse sin energía” abordamos el límite que aparece cuando la capacidad de cómputo crece más rápido que la red eléctrica. TorchNeuron encaja en esa misma transición: el rendimiento de la IA depende tanto del modelo como de la ruta completa que lo lleva hasta el silicio.
Fuentes consultadas
- AWS: anuncio de TorchNeuron y soporte nativo de PyTorch para Trainium
- PyTorch: presentación del backend nativo TorchNeuron
- Amazon Science: la ciencia detrás de TorchNeuron
- Documentación de AWS Neuron: TorchNeuron y APIs de PyTorch
- AWS Neuron: notas de la versión 2.33.0
- Hugging Face: TorchNeuron y los flujos nativos de PyTorch
La portabilidad no hace que todos los chips rindan igual. Hace que sea más difícil justificar una elección sin medirla.