Bajada. Un equipo de la Universidad de Tohoku y AISIN presentó un SoC de 16 nanómetros que guarda el sistema operativo y los pesos del modelo dentro del propio chip. En una demostración con Tiny YOLOv3, el sistema pasó de encender a iniciar el sistema operativo en 65,7 milisegundos y redujo la energía de inferencia a 50,7 mJ por fotograma.
La próxima batalla de la IA no se librará únicamente con modelos más grandes. En muchos vehículos, robots, cámaras y dispositivos industriales, el problema es más físico: cada dato que sale del chip hacia una memoria externa consume tiempo, energía y ancho de banda. Si la IA debe reaccionar en el lugar donde ocurre el trabajo, mover menos datos puede ser más importante que añadir otra capa de complejidad al modelo.
El hecho: una memoria que se queda junto al cálculo
El 2 de noviembre de 2026, la Universidad de Tohoku y AISIN anunciaron un sistema en chip (SoC) de 16 nm FinFET con 32 MB de memoria STT-MRAM integrada. El anuncio se realizó durante la IEEE Asian Solid-State Circuits Conference 2026, celebrada en Hsinchu, Taiwán.
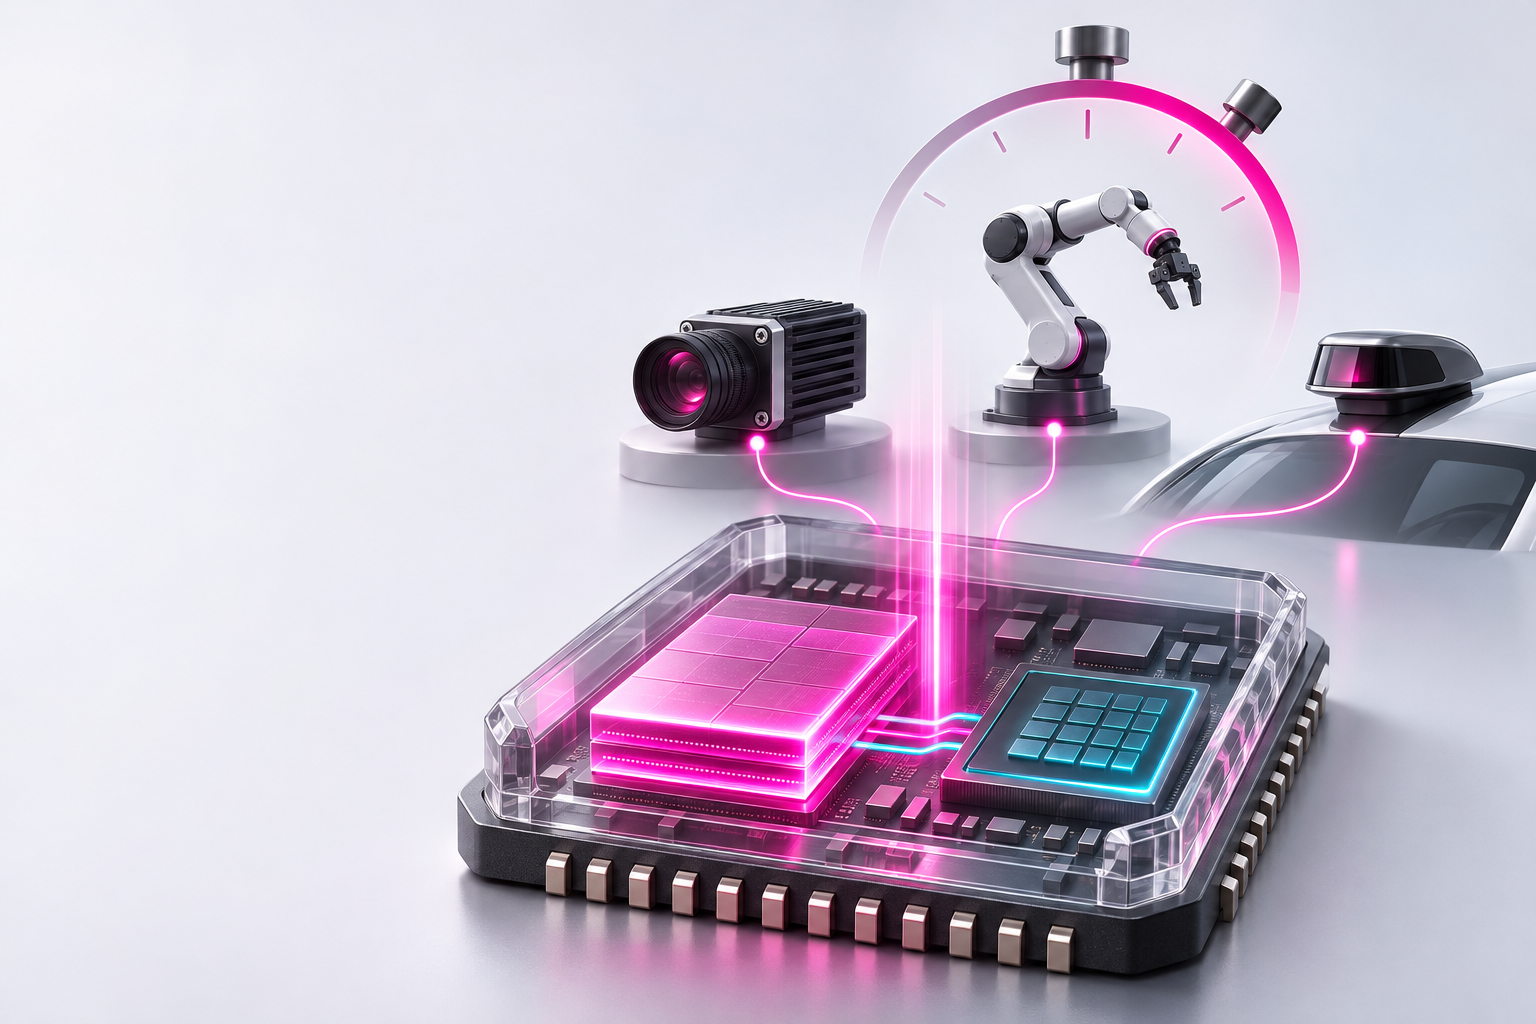
La STT-MRAM es una memoria no volátil: conserva la información cuando se corta la alimentación. En este diseño, el equipo almacenó en ella dos piezas que normalmente deben viajar desde componentes externos: los datos de arranque del sistema operativo y los pesos del modelo de IA. La arquitectura también integra una CPU Arm Cortex-A53 de doble núcleo, una GPU Arm Mali-G31 y un acelerador de IA.
El resultado presentado por los investigadores es concreto, pero también acotado: una demostración de detección de objetos con Tiny YOLOv3. No es una prueba de que cualquier modelo de IA pueda abandonar la memoria externa ni una promesa de producto comercial listo para instalar. Es una prueba de que el cuello de botella de la memoria puede atacarse desde el diseño del sistema, no solo desde el software.
65,7 milisegundos: qué significa realmente
En el sistema de referencia, el arranque desde el encendido hasta el inicio del sistema operativo requería 2.535,3 milisegundos. El prototipo lo redujo a 65,7 milisegundos: 38,59 veces más rápido, según la medición comunicada por Tohoku y AISIN.
La diferencia no procede de una magia algorítmica. El diseño evita inicializar la memoria externa y copiar desde un SSD hacia la DRAM los datos que el procesador necesita antes de empezar a trabajar. El sistema también lee directamente desde la STT-MRAM los pesos que necesita para la detección.
En la prueba de Tiny YOLOv3, el tiempo de procesamiento bajó de 594,6 a 58,5 milisegundos, una reducción de 10,16 veces. Considerando el sistema completo, los autores reportan una mejora de 25,2 veces. La energía necesaria para detectar objetos en un fotograma fue de 50,7 mJ, aproximadamente una cincuentava parte de la configuración de comparación.
Hay otra decisión técnica detrás de esos números. El chip combina multiplicaciones de 8 y 16 bits y utiliza reutilización de pesos para aprovechar mejor sus 32 MB. El comunicado indica que el tamaño de los pesos cayó de 17,7 MB a 9,36 MB, una reducción del 53 %. La métrica mAP pasó de 0,325 a 0,316: una pérdida pequeña en esa prueba, pero que recuerda que toda compresión o cuantización tiene un coste que debe medirse en el caso de uso real.
La lectura Olbrite: la latencia empieza antes de la inferencia
En la conversación sobre IA solemos medir la latencia desde que el modelo recibe una entrada hasta que devuelve una respuesta. En el borde, la cuenta empieza antes: encender el equipo, inicializar la memoria, mover el modelo, preparar el sistema operativo y recién entonces inferir.
Ese tiempo invisible decide si una cámara puede reaccionar al instante, si un robot puede recuperarse después de un corte breve o si un vehículo tiene que mantener encendidos más componentes de los necesarios. También influye en la autonomía de un dispositivo y en la cantidad de datos que debe circular dentro de una máquina.
La tesis es sencilla: la eficiencia de la IA no depende solo de cuántas operaciones ejecuta un modelo, sino de cuántas veces debe trasladar sus datos. El SoC de Tohoku y AISIN convierte la memoria en parte de la arquitectura de producto. El modelo, el arranque y el acelerador dejan de ser tres capas separadas y pasan a diseñarse como una misma restricción.
En nuestro análisis sobre la arquitectura eléctrica de 800 V para centros de datos, la conclusión era parecida desde otra escala: la infraestructura tiene que responder al comportamiento del cómputo. Aquí el movimiento ocurre dentro del dispositivo. En ambos casos, la ventaja no está en añadir capacidad sin límite, sino en acortar el camino entre energía, memoria y decisión.
Qué puede cambiar para una empresa
Operaciones. Un sistema que arranca en decenas de milisegundos puede recuperarse con menos demora después de una interrupción y responder mejor a eventos intermitentes. Eso puede ser útil en inspección industrial, control de calidad, logística y robótica, siempre que el resto de la cadena también esté preparada para esa velocidad.
Producto. La detección local reduce la dependencia de una conexión permanente con la nube. Un fabricante puede diseñar funciones que sigan activas en zonas con mala conectividad o que no envíen imágenes sensibles fuera del dispositivo.
Coste. Menos transferencias externas pueden significar menos consumo y menos componentes en ciertos diseños. Pero el ahorro no debe calcularse solo con el dato de 50,7 mJ por fotograma: también hay que incluir fabricación, memoria integrada, refrigeración, mantenimiento y el coste de adaptar el modelo.
Datos y riesgo. Procesar cerca de la fuente puede reducir la exposición de imágenes, audio o señales operativas. No elimina los riesgos: el firmware, los pesos del modelo, las actualizaciones y la protección física del dispositivo siguen necesitando controles.
Sostenibilidad. La reducción de energía por inferencia es relevante cuando se multiplica por millones de sensores o por operaciones continuas. La cifra del prototipo no es automáticamente una proyección de consumo de flota; debe validarse con el modelo, la frecuencia de inferencia y las condiciones térmicas reales.
Arquitectura. El equipo de producto ya no debería preguntar solamente qué modelo usar. También debe decidir qué datos pueden permanecer en el chip, qué precisión es suficiente, cuánto tiempo de arranque se admite y qué ocurre cuando la memoria integrada no alcanza.
Qué hacer esta semana
- Medir el coste de mover datos. En un flujo de visión o sensores, separa el tiempo de captura, transferencia, preparación, inferencia y respuesta. Sin esa medición es fácil optimizar el modelo equivocado.
- Identificar cargas que necesitan autonomía. Prioriza funciones donde la respuesta local, la continuidad tras un corte o la privacidad tengan valor económico claro.
- Definir un presupuesto de modelo. Fija límites de memoria, energía, temperatura y precisión antes de elegir entre cuantización, poda, reutilización de pesos u otra técnica.
- Probar el peor caso. Evalúa arranque en frío, actualizaciones, pérdida de alimentación, cambios de iluminación y degradación del sensor. Un benchmark de laboratorio no sustituye una operación completa.
- Separar demostración de disponibilidad. El resultado de Tohoku y AISIN merece seguimiento, pero todavía faltan datos sobre producción, rendimiento sostenido, durabilidad de la memoria, herramientas de desarrollo y disponibilidad comercial.
Lo que todavía no sabemos
El anuncio no establece cuándo llegará el diseño a un producto de volumen ni cuánto costará fabricarlo en distintas condiciones. Tampoco demuestra el comportamiento con modelos generativos, redes más grandes o cargas que necesiten escribir de forma intensiva en la memoria. La prueba utiliza Tiny YOLOv3, un modelo compacto elegido para un escenario de borde.
Por eso, la noticia no significa que la memoria externa vaya a desaparecer. Significa que la separación rígida entre procesador, memoria y almacenamiento tiene un coste que cada vez más productos tendrán que justificar. En algunos casos seguirá ganando la flexibilidad de una arquitectura convencional; en otros, la rapidez y el consumo de una memoria cercana al cálculo pueden valer más que la capacidad sobrante.
Fuentes consultadas
- Universidad de Tohoku: anuncio técnico del SoC con STT-MRAM
- AISIN: comunicado conjunto del 2 de noviembre de 2026
- PDF del comunicado técnico conjunto
- IEEE Asian Solid-State Circuits Conference 2026
La IA de borde no se vuelve útil cuando el modelo cabe en una diapositiva. Se vuelve útil cuando puede encenderse, mirar y decidir sin desperdiciar el tiempo y la energía en trasladar lo que ya tiene al lado.