En diseño de materiales, el laboratorio suele ser el lugar donde una hipótesis se vuelve cara. Cada formulación exige tiempo, muestras, equipos y una cadena de pruebas que puede descartar semanas de trabajo. Un estudio publicado el 9 de noviembre en Nature Communications propone mover una parte de ese filtro hacia la simulación: usar un campo de fuerzas de aprendizaje automático para estimar propiedades de polímeros a partir de cálculos cuánticos, sin entrenarlo directamente con datos experimentales.
La promesa no es reemplazar al laboratorio. Es llegar a él con menos opciones arbitrarias y mejores preguntas.
El cambio no es un chatbot: es una nueva capa de simulación
Los polímeros combinan interacciones a escalas muy distintas. Los métodos cuánticos pueden describir con precisión el comportamiento de los átomos, pero resultan demasiado costosos para simular cadenas grandes durante periodos largos. Los campos de fuerzas clásicos son mucho más rápidos, aunque dependen de parámetros ajustados para familias concretas de materiales y pueden perder precisión cuando se salen de ese territorio.
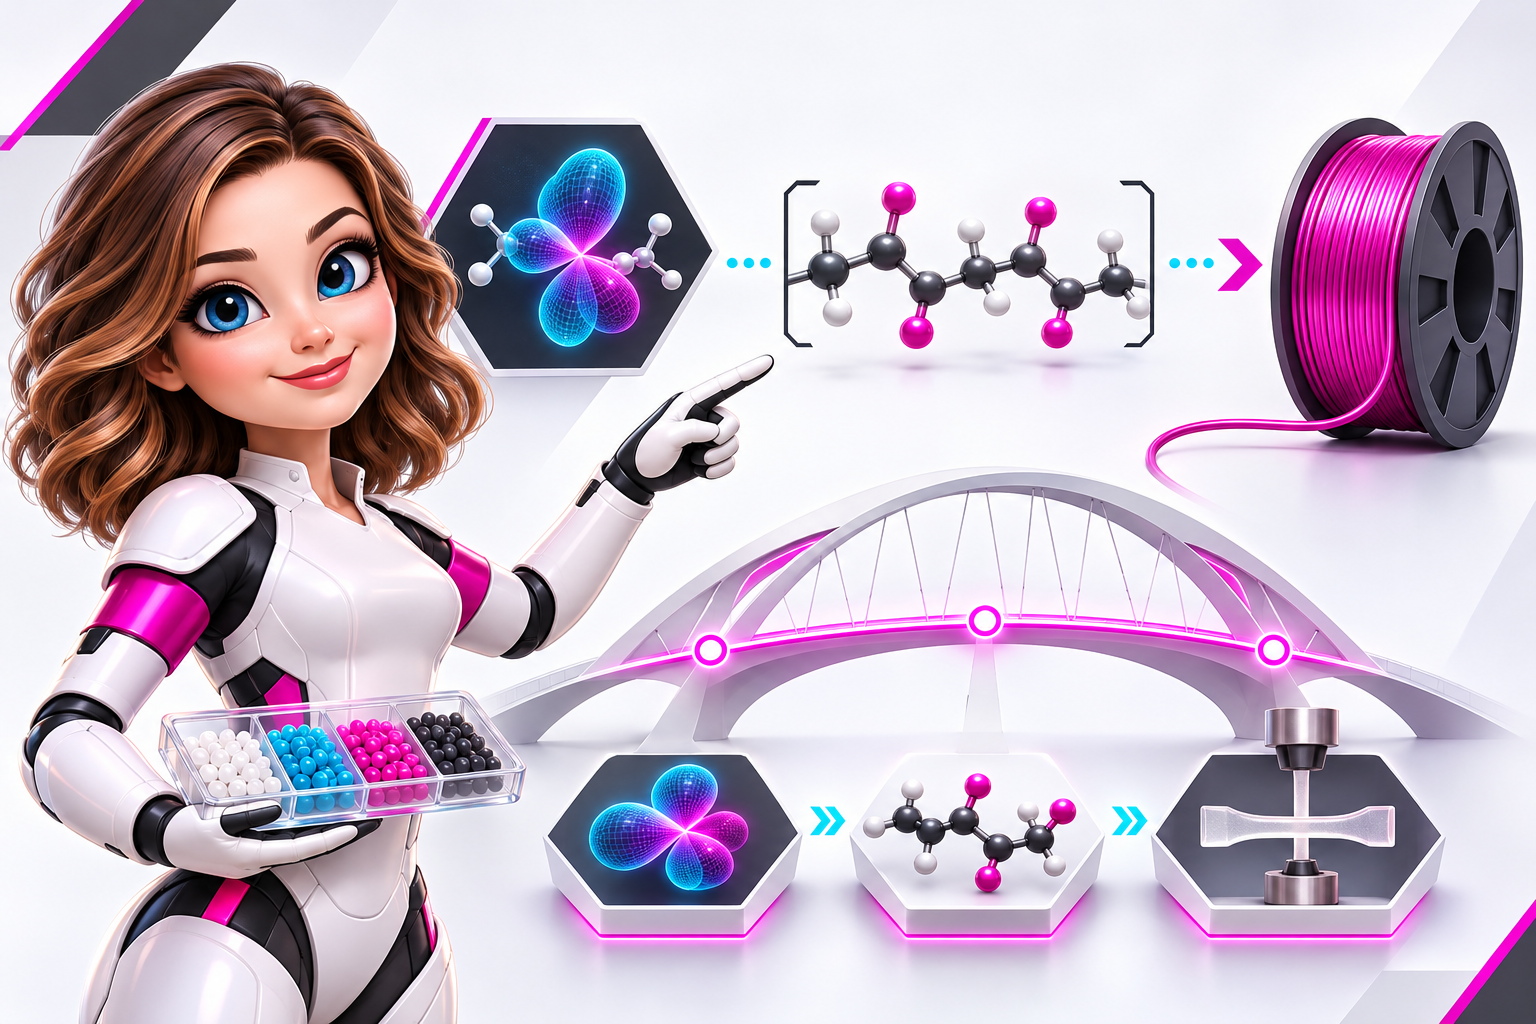
El trabajo SimPoly: Simulation of polymers with machine learning force fields derived from first principles intenta ocupar ese espacio intermedio. Su modelo aprende relaciones entre energía, fuerzas y estructura con datos de química cuántica y después las usa en simulaciones de dinámica molecular a una escala más cercana a la de un material real.
La diferencia importante está en el tipo de validación. El equipo no se limita a medir si el modelo reproduce una base de datos computacional: compara propiedades macroscópicas simuladas con valores experimentales de polímeros.
Qué aporta SimPoly
El estudio presenta tres piezas que se refuerzan entre sí:
- Vivace, un campo de fuerzas de aprendizaje automático rápido y escalable, basado en una red neuronal equivarante a SE(3), diseñada para respetar cómo cambian las propiedades cuando se rota o traslada un sistema.
- PolyData, un conjunto de datos de estructuras poliméricas y etiquetas de química cuántica para entrenar y ajustar modelos en sistemas periódicos y no periódicos.
- PolyArena, un benchmark con propiedades experimentales de 130 polímeros, en particular densidad y temperatura de transición vítrea, para evaluar si los resultados computacionales se parecen al material observado.
Según el artículo, Vivace fue entrenado exclusivamente con datos computacionales, sin incorporar los valores experimentales a su entrenamiento. En la predicción de densidad, el modelo alcanzó un error absoluto medio de 0,04 g/cm³ para polímeros incluidos en el entrenamiento y de 0,06 g/cm³ para cinco polímeros reservados como no vistos. En la comparación del estudio, los campos clásicos PCFF y OPLS3e obtuvieron 0,07 g/cm³ y 0,10 g/cm³, respectivamente.
El mismo enfoque también reprodujo la señal de una transición de segundo orden al enfriar el material, lo que permitió estimar temperaturas de transición vítrea. Es un resultado relevante porque conecta una representación atómica con una propiedad que importa en fabricación, procesado y uso final.
Hay que leer las cifras con cuidado. No todos los polímeros pudieron simularse con todos los modelos: el artículo registra fallos por inestabilidad numérica o incompatibilidades químicas, y algunos modelos se aplicaron solo a un subconjunto por su coste. El benchmark, por tanto, no es una licencia para prometer precisión universal.
Por qué importa fuera de la academia
La consecuencia empresarial no es que una compañía pueda pulsar un botón y recibir el plástico perfecto. Es más concreta: la simulación puede convertirse en una etapa de priorización antes de comprometer capacidad de laboratorio y fabricación.
1. Menos pruebas ciegas
En envases, electrónica, automoción o componentes industriales, una propiedad como la densidad o la temperatura de transición vítrea puede descartar una formulación antes de fabricar prototipos. Un modelo que ayude a ordenar candidatos no elimina las pruebas físicas, pero puede reducir el número de combinaciones que llegan a ellas.
2. Mejor exploración de materiales no familiares
El resultado sobre cinco polímeros no vistos es una señal de generalización, no una garantía de transferencia a cualquier química. Para un equipo de I+D, la pregunta útil es si la herramienta puede ampliar el espacio de búsqueda sin esconder cuándo está extrapolando.
3. Un puente entre investigación y operaciones
El valor aparece cuando el resultado computacional se conecta con decisiones: qué material comprar, qué formulación sintetizar primero, qué propiedad medir y qué riesgo aceptar. Sin ese circuito, la IA solo añade otra tabla a la carpeta de investigación.
4. Benchmarks que obligan a demostrar utilidad
PolyArena introduce una disciplina que falta en muchas demostraciones de IA: medir contra propiedades que existen fuera del ordenador. Para una empresa, esa lógica es aplicable a cualquier proyecto científico asistido por modelos: definir por adelantado qué observación física validará el resultado.
La lectura Olbrite: la ventaja está en el filtro, no en sustituir la evidencia
El titular fácil sería decir que la IA diseña materiales sin laboratorio. El estudio no demuestra eso. Demuestra algo más útil: un modelo entrenado con primeros principios puede acercarse a propiedades macroscópicas y ayudar a decidir qué vale la pena investigar.
Esa distinción cambia la estrategia. El laboratorio deja de ser el primer lugar donde se descubre si una hipótesis tenía sentido y pasa a ser el lugar donde se confirma, se mide la incertidumbre y se encuentran los efectos que la simulación no capturó.
Para una organización, la arquitectura de trabajo debería tener tres capas:
- Simulación para explorar: generar y ordenar candidatos con un coste bajo frente a la experimentación completa.
- Validación física para aprender: comprobar propiedades, registrar condiciones de preparación y devolver los resultados al ciclo de investigación.
- Gobernanza para decidir: conservar versiones del modelo, datos de entrenamiento, rangos de confianza y criterios para detener una recomendación.
La tercera capa es la que suele faltar. Un número preciso no equivale a una predicción confiable si el material, la preparación o las condiciones se alejan de los datos que el modelo conoce.
Qué puede hacer un equipo esta semana
- Elegir una decisión real de materiales —por ejemplo, priorizar formulaciones para un prototipo— y definir qué propiedad medirá el éxito.
- Separar el conjunto de candidatos en materiales conocidos y no vistos; reportar el error de cada grupo, no solo el promedio general.
- Exigir una comparación con un método clásico y con una medición experimental, incluyendo el coste computacional y el tiempo de laboratorio.
- Registrar las condiciones de preparación de las muestras. El propio estudio advierte que densidad y temperatura de transición vítrea dependen del procesamiento y del método de medida.
- Tratar cada predicción como una propuesta de experimento hasta que una medición independiente la confirme.
El límite está todavía dentro del modelo
SimPoly abre una vía, pero también deja claro dónde no conviene exagerar. Las interacciones no covalentes de largo alcance, como las electrostáticas, no están representadas explícitamente en el modelo y pueden ser decisivas en determinados polímeros. Además, los campos de fuerzas clásicos siguen siendo al menos un orden de magnitud más rápidos que los modelos de aprendizaje automático comparados.
El benchmark también hereda la variabilidad del mundo físico: la muestra y su procesado afectan la densidad, mientras que la temperatura de transición vítrea depende de la velocidad y de la técnica de medición. La comparación correcta no es entre una cifra simulada y una verdad absoluta, sino entre un rango de predicción y un protocolo experimental bien documentado.
El siguiente salto será comprobar si estos modelos pueden estimar módulos elásticos, expansión térmica y otros comportamientos de ingeniería. El artículo también señala aplicaciones más difíciles, como degradación de polímeros, reciclaje químico y reticulación dinámica. Ahí la química deja de ser una estructura fija y la validación tendrá que ser todavía más exigente.
Qué observar ahora
La señal importante de SimPoly no es un nuevo asistente de oficina, sino el avance de una IA que trabaja como instrumento científico. Si los datasets, los modelos y los protocolos se vuelven reproducibles, los equipos de materiales podrán pasar de probar formulaciones por intuición a construir campañas de experimentación con una lógica explícita de exploración, descarte y aprendizaje.
El laboratorio no desaparece. Cambia de posición en la cadena de valor: menos punto de partida para cada hipótesis y más árbitro de las que merecen convertirse en producto.
Más contexto en Olbrite
- La IA que encuentra antibióticos no trabaja sola: el laboratorio sigue teniendo la última palabra: un caso distinto, pero con la misma lección sobre el salto entre una predicción computacional y una validación física.
- La reproducibilidad de una IA puede romperse antes de que empiece a aprender: por qué una cifra repetible no siempre significa que el resultado sea predecible.
Fuentes consultadas
La noticia principal de esta pieza es la publicación de SimPoly en Nature Communications el 9 de noviembre de 2026; el preprint de arXiv se incluye como contexto técnico porque conserva el detalle metodológico del trabajo.