La IA ya tiene un examen más incómodo: entrenar agentes para reparar software
Bajada. MLPerf Training v6.1 incorpora por primera vez una prueba de postentrenamiento para agentes que aprenden a resolver tareas de ingeniería de software. La señal importante no es quién marca el tiempo más bajo: es que la infraestructura empieza a medirse por su capacidad para sostener ciclos de prueba, ejecución y aprendizaje.
La pregunta dejó de ser «¿cuánto tarda en entrenar?»
Durante años, las comparativas de infraestructura de IA se parecían a una carrera de velocidad: alcanzar una calidad objetivo, con un modelo concreto, en el menor tiempo posible. MLCommons acaba de añadir una pregunta más difícil: ¿puede el sistema ayudar a un agente a reparar software y aprender de ese proceso?
El 16 de noviembre, MLCommons publicó los resultados de MLPerf Training v6.1. La nueva edición mantiene las pruebas de entrenamiento tradicionales, pero incorpora dos cargas de trabajo: un modelo de recomendación generativa y Qwen3.5-397B GRPO, una prueba de postentrenamiento con aprendizaje por refuerzo para tareas de ingeniería de software. En la descripción de MLCommons, el agente debe trabajar con llamadas a herramientas y resolver proyectos reales de software.
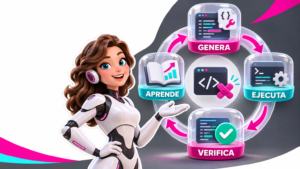
Ese cambio convierte el benchmark en una fotografía más útil de la IA que las empresas están intentando desplegar: sistemas que no solo generan una respuesta, sino que ejecutan, prueban, reciben una señal y vuelven a intentar.
Qué cambió en los resultados
La edición v6.1 reunió 153 sistemas y 250 resultados. De ellos, 57 sistemas —el 37 %— fueron basados en la nube. Doce utilizaron 1.000 aceleradores o más y el sistema de mayor escala llegó a 10.240 aceleradores. MLCommons también registró hardware de NVIDIA, AMD y Google, incluida la primera participación de aceleradores de la generación Rubin de NVIDIA y TPUv7 (Ironwood) de Google.
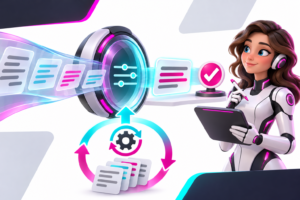
La novedad más relevante para el trabajo con agentes es la prueba Qwen3.5-397B GRPO. No mide simplemente una inferencia aislada: separa el entrenamiento de la generación de trayectorias y evalúa un ciclo en el que el modelo aprende a resolver tareas de software mediante herramientas. Esa arquitectura obliga a coordinar memoria, red, ejecución de código y evaluación, no solo a conectar más aceleradores.
Google Cloud publicó resultados propios sobre la misma ronda. En su configuración con 640 TPU Ironwood, alcanzó en 18,02 minutos el objetivo de precisión de la prueba de aprendizaje por refuerzo agéntico: 0,765 frente a un objetivo de 0,69. La empresa afirma que las unidades de entrenamiento estuvieron esperando menos del 3 % del tiempo porque la generación de código y el aprendizaje se ejecutaron en paralelo. Son resultados de un participante, no una conclusión universal sobre todos los sistemas, pero ilustran la clase de cuello de botella que ahora importa.
La lectura Olbrite: el activo escaso es el ciclo de aprendizaje
La tesis es sencilla: la siguiente ventaja de la IA empresarial no dependerá únicamente del modelo, sino de cuántas iteraciones confiables puede completar una organización por unidad de tiempo y coste.
Un agente que repara software necesita más que un modelo grande. Necesita un entorno aislado donde ejecutar código, datos de evaluación que no se contaminen, observabilidad para saber por qué falló y una forma de convertir los resultados en nuevas señales de entrenamiento. Si una de esas piezas se atasca, añadir aceleradores puede aumentar la factura sin acortar el aprendizaje.
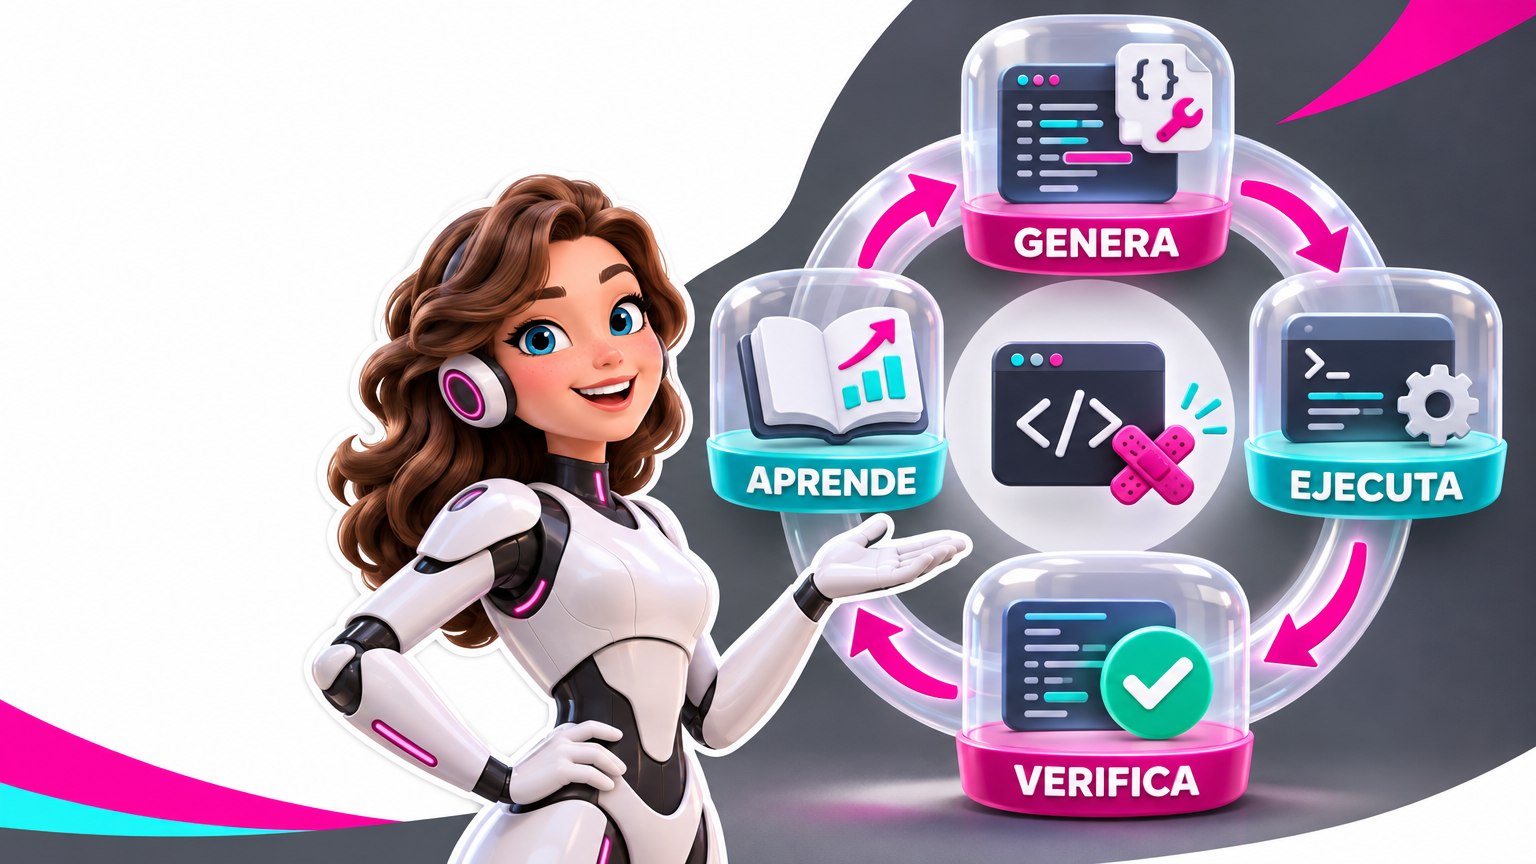
Por eso este resultado importa incluso a empresas que nunca entrenarán un modelo de 397.000 millones de parámetros. El benchmark pone nombre a una arquitectura que se repetirá en tareas más pequeñas: generación, ejecución, verificación y actualización. La pregunta de compra deja de ser «¿qué modelo responde mejor?» y pasa a ser «¿qué sistema nos permite probar más hipótesis sin perder control?».
Qué cambia para una empresa
Operaciones. Los equipos pueden automatizar más pasos, pero deberán medir el tiempo completo del ciclo: preparar contexto, ejecutar herramientas, validar el resultado y corregirlo. La latencia de una respuesta no representa el coste real de una tarea agéntica.
Personas. El valor no está en eliminar la revisión humana de golpe. Está en desplazarla hacia las decisiones de mayor riesgo: definir criterios, revisar excepciones y aprobar cambios con impacto.
Producto. Un sistema que aprende de tareas reales necesita un conjunto de pruebas que evolucione con el producto. Sin esa batería, las mejoras pueden ser solo una impresión subjetiva.
Riesgo. La ejecución de código y el uso de herramientas amplían la superficie de ataque. Los entornos aislados, los permisos mínimos y la trazabilidad de cada acción deben formar parte de la arquitectura, no añadirse después.
Coste. Hay que comparar coste por tarea verificada, no solo coste por token o por hora de acelerador. Un sistema más lento que evita reintentos inútiles puede ser más barato en producción.
Ventaja competitiva. La organización que aprende más rápido de sus propios datos operativos puede mejorar procesos antes que quien solo cambia de modelo cada pocos meses.
Qué hacer esta semana
- Elegir una tarea repetible y verificable. Por ejemplo, corregir una incidencia con pruebas automatizadas o clasificar una excepción con una condición de salida clara.
- Medir el ciclo completo. Registra tiempo de preparación, llamadas a herramientas, ejecuciones fallidas, revisión humana y resultado aceptado.
- Crear una evaluación pequeña pero real. Incluye casos normales, casos límite y ejemplos que no deben resolverse de forma automática.
- Separar experimento y producción. El agente debe trabajar en un entorno con permisos y datos limitados antes de tocar sistemas críticos.
- Definir un umbral de parada. Si el sistema repite errores, eleva el caso a una persona; no conviertas el reintento infinito en una métrica de productividad.
Qué observar ahora
El siguiente paso no será celebrar un récord aislado. Conviene observar si los benchmarks incorporan más tareas de largo recorrido, si las mediciones incluyen coste energético y si los resultados siguen siendo comparables entre nubes y centros de datos propios. También será importante saber cuánto de la mejora procede del hardware, cuánto del software de entrenamiento y cuánto de la ingeniería del entorno de evaluación.
MLPerf es una medición de sistemas concretos bajo condiciones definidas, no una promesa de rendimiento para cualquier empresa. La puntuación tampoco demuestra por sí sola que un agente sea seguro, fiable o rentable en un proceso real. Sirve para acotar la conversación y hacer visibles los componentes que antes quedaban escondidos.
Para seguir la conversación en Olbrite
- La confianza en la IA empieza a medirse: el protocolo que puede cambiar las compras empresariales, porque una prueba repetible es el puente entre una demo y una decisión de compra.
- La IA empresarial se divide en dos cuellos de botella: seguridad y memoria, para entender por qué la infraestructura condiciona la calidad de una aplicación de IA.
- Los detectores de IA también tienen que aprender en producción, una lectura complementaria sobre adaptación, evaluación y trazabilidad después del despliegue.
Fuentes consultadas
- MLCommons — MLPerf Training v6.1 Results (16 de noviembre de 2026)
- MLCommons — MLPerf Training v6.1: Bigger Clusters, Broader Hardware (17 de noviembre de 2026)
- Google Cloud — New AI training performance benchmarks for Google TPUs and NVIDIA GPUs on Google Cloud (16 de noviembre de 2026; actualizado el 18 de noviembre)
La próxima carrera de la IA no será solo por tener un modelo más grande. Será por aprender, comprobar y corregir sin perder el control del sistema.