El debate entre la potencia de los modelos propietarios cerrados y la soberanía de los pesos abiertos acaba de recibir su sacudida más contundente del año. Tencent ha publicado y liberado bajo licencia permisiva Apache 2.0 su nuevo buque insignia: Tencent Hy4 preview, un modelo de lenguaje de 770.000 millones de parámetros totales construido sobre una arquitectura Mixture-of-Experts (MoE) que activa únicamente 49.000 millones por token y ofrece una ventana de contexto superior a 1 millón de tokens.
A diferencia de lanzamientos que restringen el uso comercial mediante cláusulas de usuarios activos o licencias propietarias híbridas, la decisión de Tencent de liberar las ponderaciones completas en Hugging Face, GitHub y ModelScope bajo Apache 2.0 marca un punto de inflexión. Para los directores de tecnología y líderes de operaciones, este movimiento redefine lo que es viable desplegar dentro del perímetro de seguridad corporativo sin pagar peaje continuo a proveedores de nube cerrados.
La anatomía de Hy4 preview: capacidad de frontera sin la factura de un modelo denso
Mantener un modelo de 770.000 millones de parámetros en inferencia continua solía ser un desafío prohibitivo para la gran mayoría de las organizaciones. La arquitectura de Hy4 preview resuelve este cuello de botella mediante una combinación estratégica de dispersión (sparsity), compresión de atención y predicción multi-token:
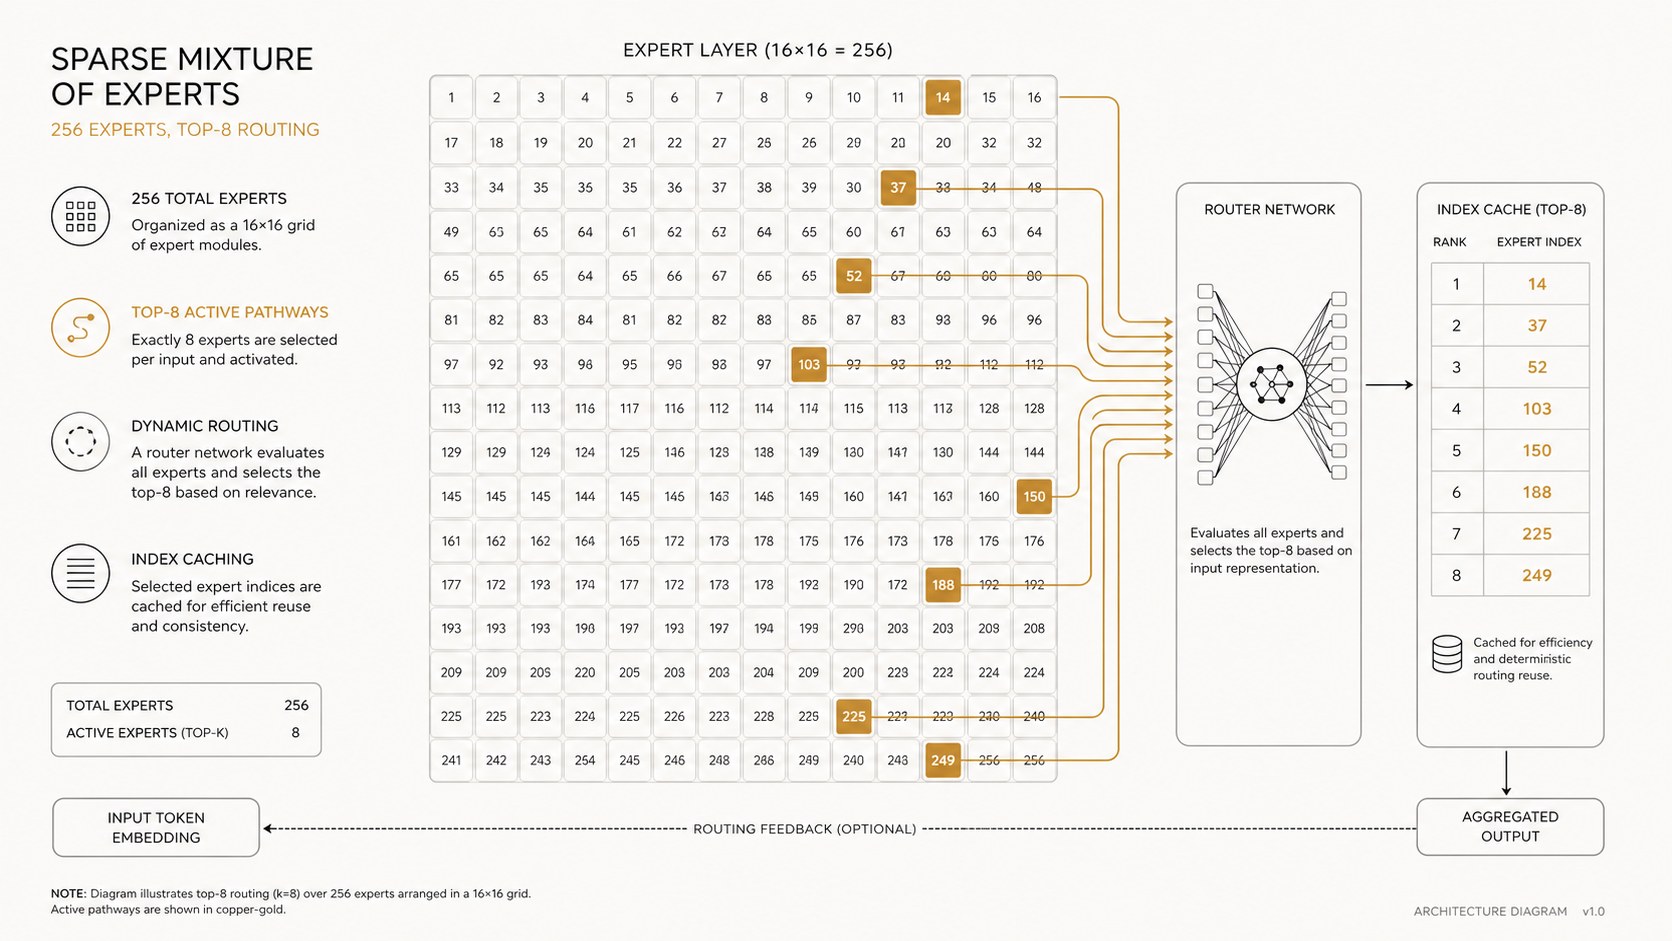
- Estructura MoE de alta granularidad: El núcleo del modelo consta de 78 capas (una capa densa inicial y 77 capas MoE). Cada capa contiene 256 expertos enrutados y 1 experto compartido. Por cada token procesado, el sistema activa únicamente los 8 expertos más relevantes más el experto compartido, lo que traduce el coste computacional de inferencia al equivalente de un modelo de apenas 49B de parámetros.
- Gated DeepSeek Sparse Attention (Gated DSA) con IndexCache: Para sostener ventanas de contexto de hasta 1 millón de tokens sin agotar la memoria VRAM, Tencent implementó atención dispersa con reutilización de índices a través de capas (IndexCache), evitando recalcular índices de atención en secuencias largas.
- Capa nativa de Multi-Token Prediction (MTP): Incorpora una capa MTP de 10B parámetros (0,7B activados) diseñada específicamente para acelerar la decodificación especulativa (speculative decoding) en 3 pasos de forma nativa.
- Variante optimizada en FP8: Publicado simultáneamente en precisión nativa y en formato cuantizado FP8 (
Hy4-preview-FP8), facilitando su despliegue directo en motores modernos de servicio como vLLM y SGLang.
Co-diseño con el producto real: el salto en código y flujos complejos
Uno de los aspectos más reveladores del comunicado oficial de Tencent es que Hy4 preview no se entrenó de forma aislada en laboratorios de investigación para perseguir tablas de clasificación sintéticas. El modelo fue co-diseñado y probado en los entornos de desarrollo y productividad masivos de la compañía, incluyendo WorkBuddy, CodeBuddy, Yuanbao e ima.
En evaluaciones a ciegas internas con más de 160 ingenieros y evaluadores expertos sobre 203 tareas reales de desarrollo de software, Hy4 preview mostró una tasa de preferencia y victorias competitivas frente a modelos de referencia abiertos de última generación (como GLM 5.3 y Kimi K3). Su comportamiento destaca especialmente en tres áreas críticas para flujos empresariales:
- Refactorización y comprensión de bases de código masivas: La combinación de 1M de contexto con IndexCache permite cargar repositorios enteros o especificaciones técnicas extensas manteniendo la fidelidad en la ejecución de cambios.
- Generación de planes de ejecución y llamadas a herramientas (Tool-Calling): Mayor robustez en tareas agentic multi-paso, reduciendo la degradación lógica cuando los flujos requieren invocar múltiples APIs en cadena.
- Razonamiento científico y computacional: Rendimiento elevado en modelado matemático, simulación y formulación estructurada de hipótesis.
¿Qué significa esto para la estrategia de IA en la empresa?
Hasta hace poco, las empresas que requerían modelos de máxima capacidad de razonamiento estaban prácticamente forzadas a utilizar APIs propietarias alojadas en nubes de terceros. Aunque estas APIs ofrecen rapidez inicial, plantean tres fricciones estratégicas a medida que la escala aumenta: soberanía de datos sensible, costes crecientes por volumen de tokens y dependencia de cambios de políticas de proveedores externos.
La llegada de un modelo con la envergadura de Hy4 preview bajo licencia Apache 2.0 abre tres oportunidades concretas:
1. Auto-hospedaje viable de modelos de clase frontera
Gracias a la activación de solo 49B de parámetros y a la cuantización FP8, las empresas con infraestructuras privadas (on-premise o VPC dedicada) pueden ejecutar un modelo de 770B con un consumo de hardware similar al de modelos medianos, garantizando que el código propietario y los datos de clientes nunca abandonen sus cortafuegos.
2. Estabilidad y control sobre los flujos de agentes
En flujos de trabajo basados en agentes autónomos, las actualizaciones no anunciadas de APIs comerciales pueden alterar el formato de salida o provocar regresiones en llamadas a herramientas. Disponer de las ponderaciones completas congeladas permite versionar, auditar y afinar el modelo exactamente según las reglas de negocio de la organización.
3. Desacoplamiento de márgenes en productos SaaS basados en IA
Para startups y proveedores de software que construyen características de IA intensivas en contexto (como asistentes de código, análisis de contratos o copilotos financieros), operar con modelos abiertos MoE reduce drásticamente el coste marginal por usuario frente a las tarifas por millón de tokens de los modelos propietarios de gama alta.
La nueva regla de decisión: ¿Cuándo usar propietario y cuándo pesos abiertos?
El lanzamiento de Hy4 preview no significa que las APIs propietarias pierdan su valor: siguen siendo la alternativa más rápida para prototipado rápido, casos de uso esporádicos o equipos sin capacidad de gestión de infraestructura. Sin embargo, traza una línea divisoria clara:
La regla operativa para 2026: Si el flujo de IA de tu empresa maneja volumen masivo de datos internos, requiere baja latencia predecible o forma parte del núcleo de tu propiedad intelectual, los pesos abiertos de frontera (Apache 2.0) ya no son un compromiso de calidad: son una ventaja de coste y control estratégico.
Con pesos disponibles de inmediato en los principales repositorios abiertos y soporte en motores de inferencia de la comunidad, Hy4 preview demuestra que el ecosistema abierto está acelerando su ritmo de entrega y cerrando la brecha con los laboratorios propietarios más rápido que nunca.