Un equipo del MIT ha diseñado una forma de entrenar emuladores climáticos con escenarios sintéticos optimizados. La señal para las empresas va más allá del clima: en los problemas caros de simular, la calidad de la pregunta puede valer más que acumular datos sin criterio.
El cuello de botella no siempre está en el modelo
Una empresa eléctrica que decide dónde reforzar una red, una aseguradora que actualiza sus mapas de riesgo o un fabricante que evalúa su exposición a sequías no necesita una predicción única. Necesita comparar muchos futuros posibles y entender qué cambia cuando cambia una variable.
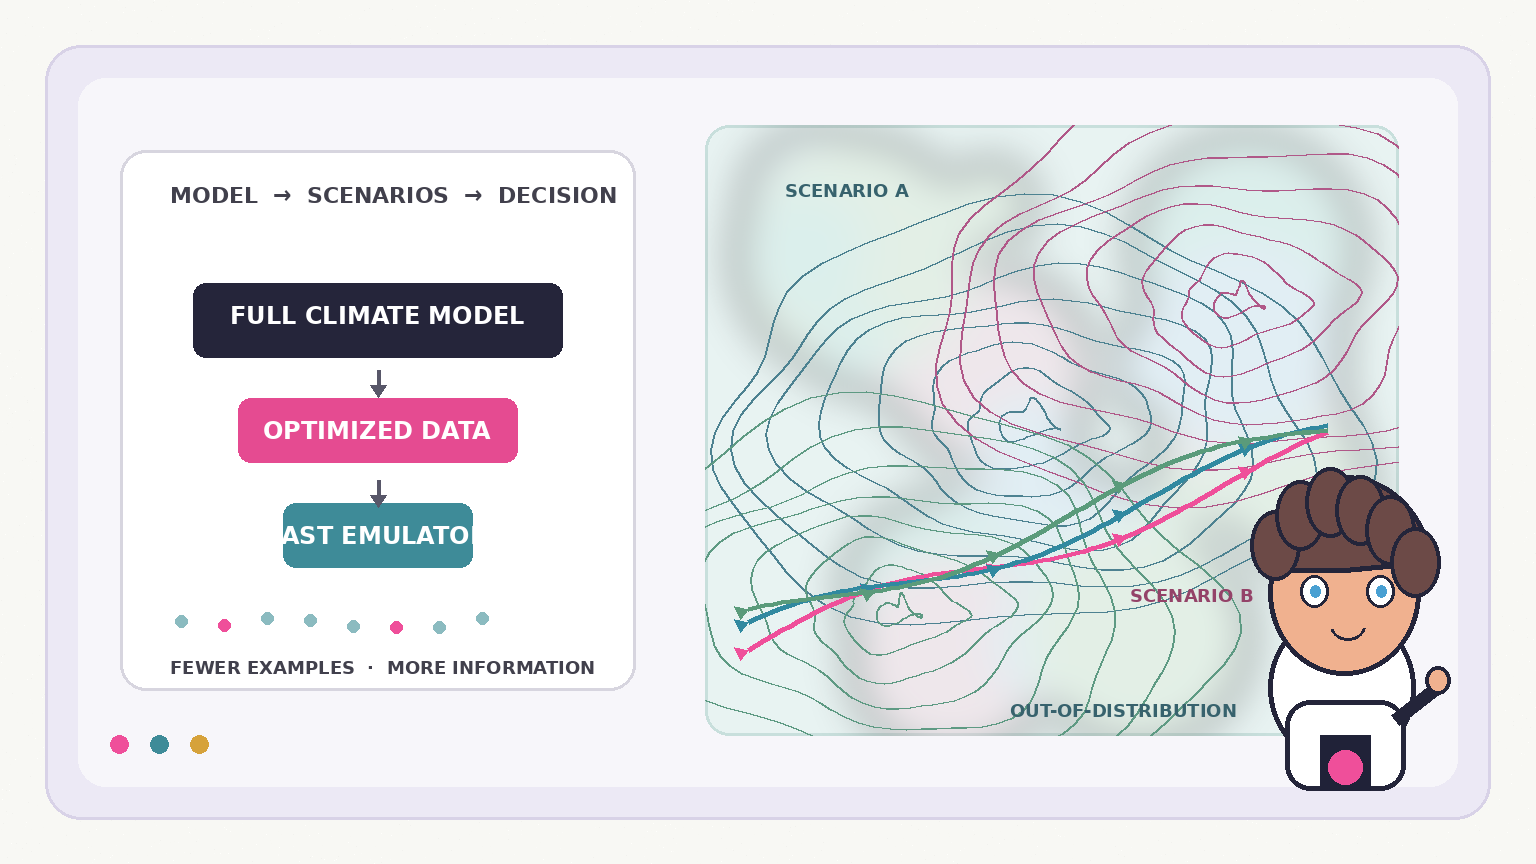
El problema es que los modelos climáticos de mayor fidelidad no están hechos para responder cientos de preguntas en una tarde. Los modelos del sistema Tierra pueden tardar meses en ejecutarse en clústeres de supercomputación, incluso para proyectar un solo escenario. Por eso los investigadores utilizan emuladores climáticos: modelos de IA que aprenden a aproximar el comportamiento de esos sistemas complejos y pueden evaluar un escenario en segundos.
La velocidad abre la puerta a explorar más opciones. Pero introduce una pregunta incómoda: ¿qué ocurre si el emulador aprende muy bien los escenarios conocidos y falla justo cuando aparece una combinación de emisiones que no vio durante el entrenamiento?
MIT cambia el foco: optimizar los datos antes que agrandar la red
El 12 de noviembre, MIT News describió una investigación sobre Optimal scenario design for climate emulation, publicada en Proceedings of the National Academy of Sciences. El equipo, dirigido por Christopher B. Womack y Noelle E. Selin, no propone empezar por una arquitectura más grande. Propone diseñar mejor los ejemplos con los que aprende el emulador.
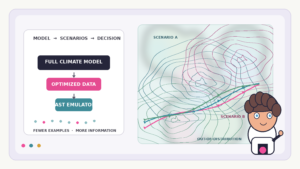
La idea se parece más al diseño de un experimento que a la recopilación indiscriminada de datos. Los investigadores parten de un escenario de emisiones, entrenan un emulador y miden su error frente a escenarios objetivo. Después calculan cómo cambiaría ese error si modificaran la trayectoria de emisiones usada como entrenamiento. Con diferenciación automática y descenso de gradiente, actualizan la trayectoria y repiten el proceso.
El resultado son escenarios sintéticos que pueden parecer poco naturales: incluyen variaciones rápidas en las emisiones de dióxido de carbono, metano, óxido nitroso, azufre y carbono negro. No se diseñan para representar una política realista, sino para obligar al modelo a distinguir respuestas físicas que quedarían mezcladas en las trayectorias convencionales.
El hallazgo principal es concreto: en el modelo climático simple utilizado por el equipo, un emulador entrenado con un escenario optimizado superó a otro entrenado con seis trayectorias estándar de ScenarioMIP. La metodología también se probó con el MIT Earth System Model, un modelo de complejidad intermedia, y conservó la ventaja de generalización frente a escenarios que no estaban en el entrenamiento.
Menos simulaciones caras, más preguntas útiles
Según la explicación de MIT, el enfoque puede reducir la preparación de los datos de entrenamiento desde seis u ocho ejecuciones de un modelo completo a una sola ejecución, que luego sirve como base para optimizar los escenarios sintéticos. Eso no significa que la ciencia climática pueda prescindir de los modelos físicos. Significa que una ejecución costosa puede aprovecharse mejor antes de volver a gastar semanas o meses de cómputo.
La distinción importa. El emulador no sustituye al modelo del sistema Tierra cuando hay que validar un resultado importante. Funciona como una capa rápida de exploración: ayuda a decidir qué escenarios merecen una simulación de alta fidelidad y cuáles no. En términos operativos, convierte el modelo caro en una fuente de evidencia y no en una cola interminable de consultas.
La versión pública del trabajo en arXiv deja además una advertencia útil: las trayectorias estándar suelen mover varias fuerzas climáticas de forma correlacionada. Un emulador puede aprender esa correlación y confundirla con la física subyacente. Los escenarios optimizados separan mejor esas señales y permiten probar respuestas a combinaciones nuevas, como reducir un contaminante mientras otros siguen aumentando.
La lectura Olbrite: el activo estratégico es la capacidad de preguntar
La noticia no trata solo de clima. Expone un patrón que muchas empresas todavía pasan por alto: cuando generar una observación es caro, la ventaja no está en recolectar más ejemplos de cualquier tipo. Está en diseñar los ejemplos que obliguen al sistema a revelar sus límites.
Esto cambia la conversación sobre IA aplicada a problemas físicos y regulados. En vez de preguntar únicamente qué modelo tiene más parámetros, conviene preguntar qué escenarios distinguen mejor entre hipótesis, qué casos de uso quedan fuera de distribución y cuánto cuesta validar una decisión equivocada.
Para una empresa, el resultado puede ser una arquitectura de decisión en dos velocidades:
- Exploración rápida: un emulador prueba miles de combinaciones, identifica sensibilidad y prioriza preguntas.
- Validación profunda: un modelo físico, un laboratorio o un experto revisa las decisiones de mayor impacto.
- Memoria de evidencia: cada escenario conserva sus datos de entrada, supuestos, versión del modelo y criterio de aceptación.
El valor no está en publicar una cifra de precisión aislada. Está en reducir el tiempo entre una hipótesis y una decisión defendible.
Qué cambia para las empresas
1. La planificación puede pasar de un pronóstico a un mapa de decisiones
Un pronóstico único puede dar una falsa sensación de certeza. Un emulador bien validado permite explorar bandas de escenarios: cambios en demanda eléctrica, disponibilidad de agua, rendimiento agrícola, interrupciones logísticas o exposición de activos. La empresa no obtiene una respuesta definitiva; obtiene una mejor visión de qué decisiones son robustas ante futuros distintos.
2. El presupuesto de cómputo puede asignarse donde aporta más evidencia
Si cada simulación de alta fidelidad tarda semanas, no tiene sentido usarla para responder preguntas de bajo impacto. Una capa rápida puede filtrar opciones, descubrir comportamientos extraños y reservar la supercomputación para las decisiones que cambian una inversión, un contrato o un plan de continuidad.
3. La estrategia de datos debe medir diversidad, no solo volumen
Cien ejemplos casi idénticos pueden enseñar menos que un conjunto pequeño pero estructuralmente diverso. La revisión de datos debería buscar correlaciones que el modelo pueda memorizar, variables que nunca cambian juntas y regiones donde una política o un shock rompa el patrón histórico.
4. La actualización del modelo se vuelve una capacidad operativa
Los escenarios económicos, regulatorios y físicos cambian antes de que termine un ciclo largo de modelado. Si el entrenamiento de un emulador puede rediseñarse con menos simulaciones completas, los equipos pueden actualizar sus herramientas con mayor frecuencia. La ventaja no es tener un modelo eterno; es detectar pronto cuándo dejó de representar la pregunta actual.
5. La gobernanza debe incluir pruebas fuera de distribución
Un modelo que funciona con los escenarios que conoce no está listo para una decisión crítica. El comité de riesgo debería exigir pruebas con combinaciones nuevas, registrar las condiciones donde el modelo pierde habilidad y definir cuándo una salida debe escalarse a un modelo físico o a una revisión humana.
Qué hacer esta semana
- Elige una decisión cara de validar. Puede ser una inversión energética, una ruta logística, un plan de seguros o una política de continuidad. Mide cuánto tarda hoy en responderse.
- Separa el simulador de alta fidelidad de la capa de exploración. Define qué preguntas puede contestar un emulador y cuáles siempre necesitan una validación profunda.
- Construye un conjunto de pruebas desconocidas. Incluye combinaciones de variables que no aparezcan juntas en el histórico y documenta por qué son relevantes.
- Registra el origen de cada escenario. Guarda supuestos, versión del modelo, datos, transformaciones, métricas y responsable de aprobación. Sin esa trazabilidad, la velocidad solo produce opacidad más rápido.
- Establece una regla de escalamiento. Si la incertidumbre es alta, la combinación está fuera de distribución o la decisión es irreversible, el resultado rápido debe activar una simulación completa y revisión experta.
Qué observar antes de confiar demasiado
La investigación todavía tiene límites claros. El equipo debe probar el método con escenarios generados por un modelo completo del sistema Tierra; la demostración más detallada parte de modelos simples o de complejidad intermedia. Además, un escenario sintético con oscilaciones rápidas es útil para aprender, pero no debe confundirse con una predicción socioeconómica.
También queda la pregunta de cómo representar incertidumbres que no están en los datos de entrenamiento: cambios tecnológicos abruptos, puntos de inflexión, errores de medición o interacciones físicas que el emulador no puede inferir. La rapidez de una salida no convierte una extrapolación en evidencia.
La práctica responsable es usar el emulador para ampliar la búsqueda y el modelo físico para poner límites a la confianza. Si ambos coinciden en una decisión importante, la señal gana fuerza. Si divergen, la divergencia es precisamente el resultado que merece investigación.
Continuidad editorial de Olbrite
Esta pieza amplía la conversación de la predicción meteorológica que llega antes que la decisión: allí la ventaja era reducir la latencia entre información y acción; aquí el problema es decidir qué futuros conviene explorar. También conecta con la IA que simula polímeros y reduce el ensayo a ciegas, porque ambos casos muestran el mismo límite: una simulación rápida puede priorizar el trabajo, pero no elimina la validación del mundo físico.
Fuentes consultadas
- MIT News: New research could lead to faster, trustworthy AI models for climate prediction, 12 de noviembre de 2026.
- Womack et al., “Optimal scenario design for climate emulation”, PNAS, 2026.
- Versión de acceso abierto en arXiv, 29 de septiembre de 2026.
- MIT Center for Sustainability Science and Strategy: resumen técnico del trabajo.
La próxima ventaja en IA científica no será alimentar el modelo con todo. Será diseñar la pregunta que lo obligue a aprender lo que importa.