AlphaGenome 2 cambia la pregunta: la misma mutación no significa lo mismo en cada célula
Google DeepMind presentó una nueva versión de su modelo genómico capaz de estudiar cómo una variante de ADN actúa en tipos y estados celulares concretos. Para la investigación biomédica, el avance no consiste en sustituir el laboratorio, sino en decidir mejor qué hipótesis merece llegar a él.
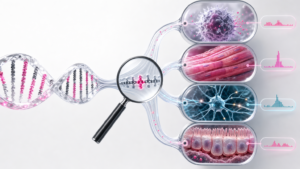
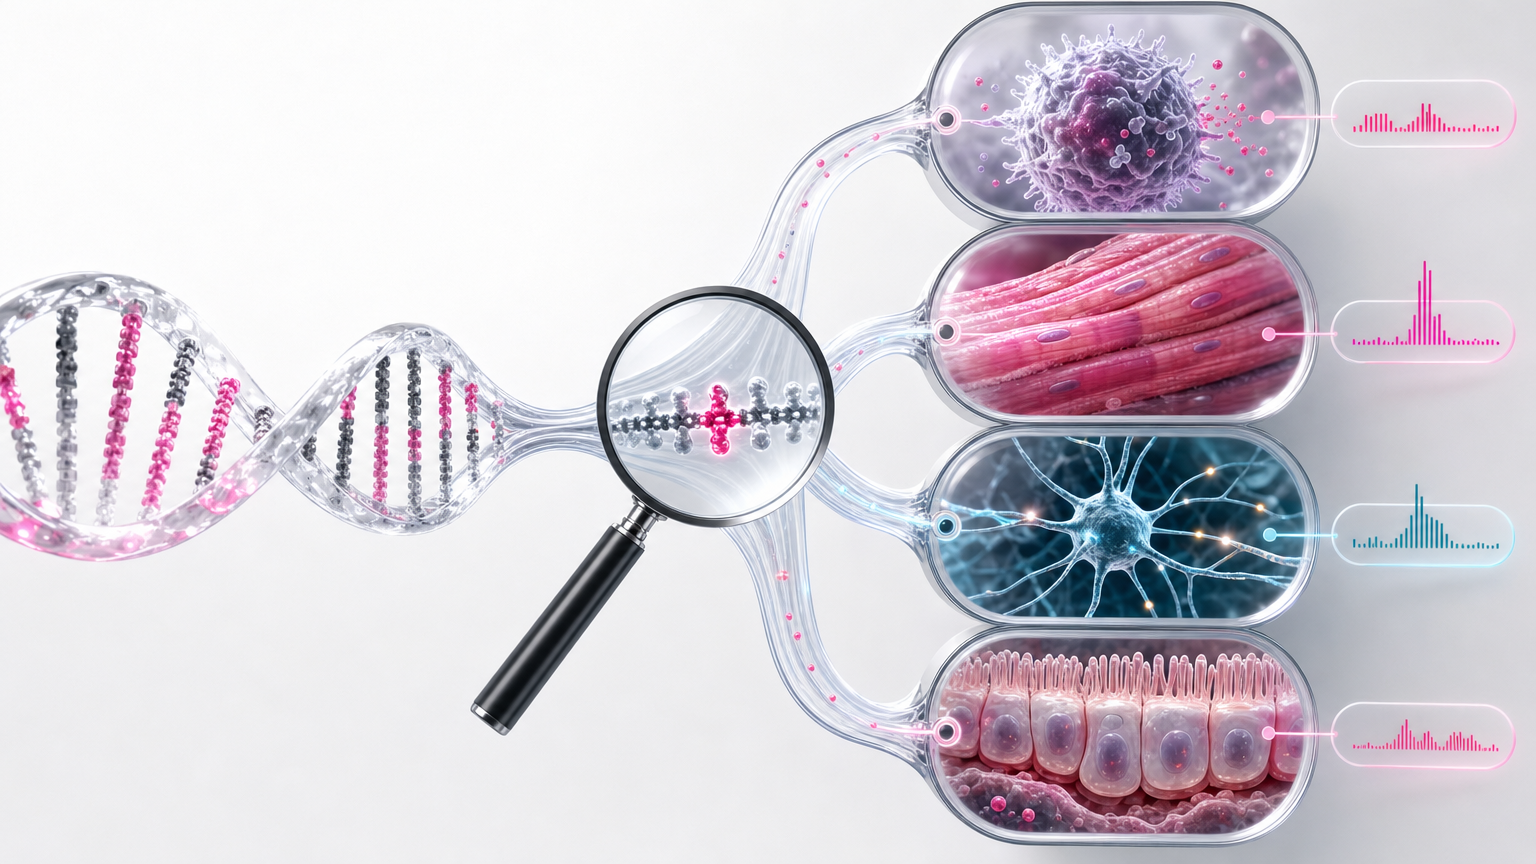
Una misma secuencia de ADN puede producir comportamientos muy distintos según la célula que la lea. Una célula inmunitaria activada no utiliza el genoma como una célula muscular del corazón; una célula intestinal enferma tampoco interpreta todas sus instrucciones igual que una célula sana. Cuando los datos se promedian por tejido, esa diferencia puede desaparecer.
Ahí está la señal relevante del anuncio de Google DeepMind del 11 de noviembre de 2026: AlphaGenome 2 intenta pasar de la predicción genómica promedio a una predicción condicionada por el contexto celular. El cambio parece técnico, pero su consecuencia empresarial es concreta: laboratorios, compañías farmacéuticas y equipos de biotecnología podrían priorizar variantes y experimentos con una hipótesis más específica antes de invertir tiempo y recursos en el laboratorio.
Cuando el promedio borra la señal
La mayoría de las variantes asociadas con rasgos y enfermedades humanas se encuentran en regiones no codificantes del ADN. No producen necesariamente una proteína distinta; pueden alterar la regulación de un gen, como un interruptor o un control de volumen. El problema es que ese efecto depende del tipo de célula y de su estado.
El modelo anterior de AlphaGenome ya podía analizar secuencias de hasta un millón de letras y predecir diferentes señales de actividad regulatoria. Pero, según el trabajo técnico de AlphaGenome 2, su primera versión trabajaba principalmente con tejidos agregados y líneas celulares, además de producir un catálogo fijo de salidas experimentales.
Ese enfoque es útil para detectar patrones amplios. Es menos adecuado cuando la pregunta es más estrecha: ¿por qué una variante aumenta la actividad de un gen en un tipo de célula inmunitaria y no en otro? ¿Qué ocurre durante la maduración de una célula? ¿Qué cambia en un estado asociado con una enfermedad?
La diferencia entre una media de tejido y una señal específica de célula no es un detalle estadístico. Puede cambiar qué variante se considera prioritaria, qué gen parece afectado y qué experimento debería hacerse después.
Qué cambia en AlphaGenome 2
AlphaGenome 2 recibe tres elementos principales:
- Una secuencia de ADN de un millón de pares de bases.
- Una condición biológica: tejido, línea celular, tipo de célula o estado celular.
- La especie que se quiere estudiar, humana o de ratón.
La condición no se añade al final como una etiqueta. El modelo la utiliza para modular sus representaciones a lo largo de la arquitectura. En términos sencillos, no solo pregunta qué hay en la secuencia, sino también qué célula la está leyendo.
El sistema puede predecir expresión génica, accesibilidad de la cromatina, modificaciones de histonas, unión de factores de transcripción, metilación CpG, señales de ARN y otras interacciones regulatorias. También puede imputar modalidades que no se hayan medido para una condición concreta, una posibilidad útil cuando un experimento tiene datos incompletos.
Para entrenarlo, DeepMind combinó datos genómicos masivos con información de célula única. El anuncio describe más de 107 millones de perfiles celulares individuales, procedentes de datos humanos y de ratón, y cobertura de 68 tejidos. El trabajo técnico detalla además 3.977 pistas de RNA-seq y ATAC-seq de célula única procedentes de 36 estudios, junto con datos de metilación celular de 185 condiciones humanas de referencia.
La otra pieza importante es la adaptación a datos nuevos. Un equipo puede aportar una instantánea de expresión génica de un experimento de célula única y utilizarla para representar un estado celular que el modelo no haya visto exactamente durante su entrenamiento, sin volver a entrenar todo el sistema.
El dato que importa: un benchmark, no una promesa clínica
En el conjunto TenK10K, que reúne 28 tipos de células inmunitarias primarias, DeepMind informa que AlphaGenome 2 identificó el 30% de las variantes causales, frente al 16% de la versión anterior ajustada con datos de célula única y otros modelos especializados. En los efectos direccionales sobre la expresión génica, el resultado informado fue del 43% frente al 23%.
El resumen del trabajo técnico presenta el resultado como una duplicación de la recuperación de eQTL causales de célula única con una precisión del 90%. Es una mejora relevante dentro de ese protocolo de evaluación. No significa que el modelo haya demostrado eficacia clínica, ni que cada predicción sea correcta fuera de los datos y condiciones evaluados.
El ejemplo de enfermedad que acompaña al anuncio es igualmente instructivo. En un caso de enfermedad inflamatoria intestinal, AlphaGenome 2 reprodujo computacionalmente un hallazgo previo: una variante regulatoria que eleva la actividad del gen ETS2 en macrófagos intestinales. El modelo no descubrió por sí solo un tratamiento ni reemplazó la validación experimental; mostró que puede recuperar un mecanismo conocido cuando se le pide mirar el contexto celular adecuado.
Esa distinción debería formar parte de cualquier lectura empresarial de la noticia. El valor está en reducir el espacio de hipótesis y ordenar mejor los siguientes experimentos, no en convertir una predicción in silico en una decisión médica.
La lectura Olbrite: el contexto se vuelve infraestructura
La tesis es simple: en la siguiente etapa de la IA aplicada a la ciencia, la ventaja no dependerá solo de tener un modelo más grande, sino de representar mejor el contexto en el que se produce cada señal.
Para una empresa de investigación, eso mueve el centro de gravedad desde el modelo aislado hacia el sistema completo de datos, hipótesis y validación.
| Área | Qué puede cambiar | Qué no conviene asumir |
|---|---|---|
| Farmacéutica y biotecnología | Priorizar variantes, genes candidatos y experimentos con una resolución celular mayor. | Que una predicción sustituya un ensayo funcional o una revisión experta. |
| I+D y descubrimiento | Aprovechar datos propios de célula única para estudiar estados nuevos sin ajustar de nuevo todo el modelo. | Que cualquier conjunto de datos pequeño sea representativo o comparable. |
| Gestión del dato | Tratar la condición celular, el protocolo y los metadatos como parte del activo científico, no como contexto accesorio. | Que el resultado sea reproducible si no se conservan entradas, versión y parámetros. |
| Compras y alianzas | Evaluar acceso, términos de uso y posibilidad de integrar el modelo en un flujo comercial. | Que la disponibilidad para investigación no equivalga a disponibilidad empresarial. |
| Riesgo y cumplimiento | Separar claramente investigación computacional, evidencia experimental y uso clínico. | Que un benchmark publicado sea una aprobación regulatoria. |
Hay un detalle de acceso que puede cambiar la decisión de compra. Google DeepMind indica que AlphaGenome 2 está disponible para investigación no comercial mediante su API y en una vista previa privada para investigación comercial a través de Google Cloud. El repositorio de la API ofrece documentación y ejemplos, pero sus términos también advierten que las predicciones son para modelado teórico e investigación y no deben utilizarse para decisiones clínicas ni para entrenar otros modelos de aprendizaje automático.
Para un laboratorio universitario, esa separación puede ser manejable. Para una farmacéutica, una startup de biotecnología o un proveedor de servicios científicos, debe entrar en la evaluación desde el primer día: quién puede usar los resultados, dónde se procesan los datos, qué versión se conserva y qué ocurre si el acceso o las condiciones cambian.
Qué hacer esta semana
- Elegir una pregunta pequeña y trazable. No empezar por “analizar el genoma”. Elegir una variante, un gen, una enfermedad o un estado celular y definir qué decisión experimental podría cambiar.
- Construir una comparación de referencia. Ejecutar una línea base con el método actual del equipo y registrar qué aporta AlphaGenome 2: variantes priorizadas, genes relacionados, señales adicionales o hipótesis descartadas.
- Documentar el contexto de la muestra. Guardar tipo celular, estado, especie, protocolo de secuenciación, calidad y fecha. Una salida sin esa ficha no es una evidencia reutilizable.
- Definir la validación antes de mirar el resultado. Acordar qué hallazgo pasará a un ensayo funcional, qué umbral detendrá el análisis y qué resultado se considerará un falso positivo útil para mejorar el proceso.
- Revisar el acceso y la licencia. Distinguir investigación no comercial, investigación patrocinada y uso comercial. El coste técnico de una prueba no es el único coste del proyecto.
La prueba de valor no debería ser cuántas variantes devuelve el sistema. Debería ser si ayuda a un equipo a tomar una mejor decisión experimental, con menos ambigüedad y con una cadena de evidencia que otro investigador pueda revisar.
Qué observar ahora
Hay cuatro señales que determinarán si AlphaGenome 2 pasa de ser un avance de investigación a una pieza habitual de los flujos biomédicos:
- Reproducción independiente: si otros equipos obtienen resultados similares en cohortes y estados celulares que no aparecen en el benchmark original.
- Generalización fuera de distribución: qué ocurre cuando las muestras proceden de poblaciones, protocolos o enfermedades distintas de los datos de entrenamiento.
- Integración con laboratorios reales: si las predicciones reducen experimentos innecesarios sin aumentar el trabajo de revisión y control.
- Marco de uso empresarial: cómo evolucionan el acceso comercial, los límites de uso, la trazabilidad y la validación de resultados.
También conviene mirar lo que el anuncio no promete. AlphaGenome 2 no es una herramienta clínica aprobada. No demuestra que una variante cause una enfermedad solo porque la puntúe alto. Y no elimina la necesidad de experimentos, controles, especialistas ni revisión regulatoria.
Una continuidad: de la señal al criterio
En los últimos días, Olbrite ha seguido una misma pregunta desde distintos ángulos. El artículo sobre PARDIG y SatWeave mostró por qué abrir nuevas capas de datos meteorológicos solo importa cuando esas observaciones pueden convertirse en decisiones operativas. Y el análisis sobre cómo medir la confianza en la IA planteó la necesidad de demostrar, con protocolos repetibles, cómo se comporta un sistema.
AlphaGenome 2 encaja en la misma secuencia: más datos no bastan. Hay que asignarles contexto, convertirlos en una hipótesis y dejar claro qué evidencia permitiría confiar en ella.
Fuentes consultadas
- Anuncio oficial de AlphaGenome 2 — Google DeepMind, 11 de noviembre de 2026
- Trabajo técnico: “AlphaGenome 2 predicts regulatory activity and variant effects across cell states”
- Página científica de AlphaGenome — Google DeepMind
- Repositorio oficial de la API de AlphaGenome
La verdadera mejora no es que la IA lea más ADN. Es que aprenda a preguntar en qué célula ocurre la señal y qué experimento puede comprobarla. En ciencia aplicada, ese cambio de contexto puede valer más que otra demostración de escala.