Durante los últimos tres años, la estrategia de adopción de inteligencia artificial en las empresas operó bajo una premisa sencilla: cualquiera con una tarjeta de crédito corporativa y una clave de API podía acceder al modelo más avanzado del planeta. La ventaja competitiva dependía de la rapidez de integración y del presupuesto disponible para consumir tokens.
En las primeras 72 horas de septiembre de 2026, esa premisa quedó formalmente obsoleta.
Entre el 1 y el 3 de septiembre, los principales laboratorios de frontera —Anthropic, Google DeepMind y OpenAI— ejecutaron movimientos sincronizados que consolidan una fractura estructural en la industria: la era de los modelos de doble régimen.
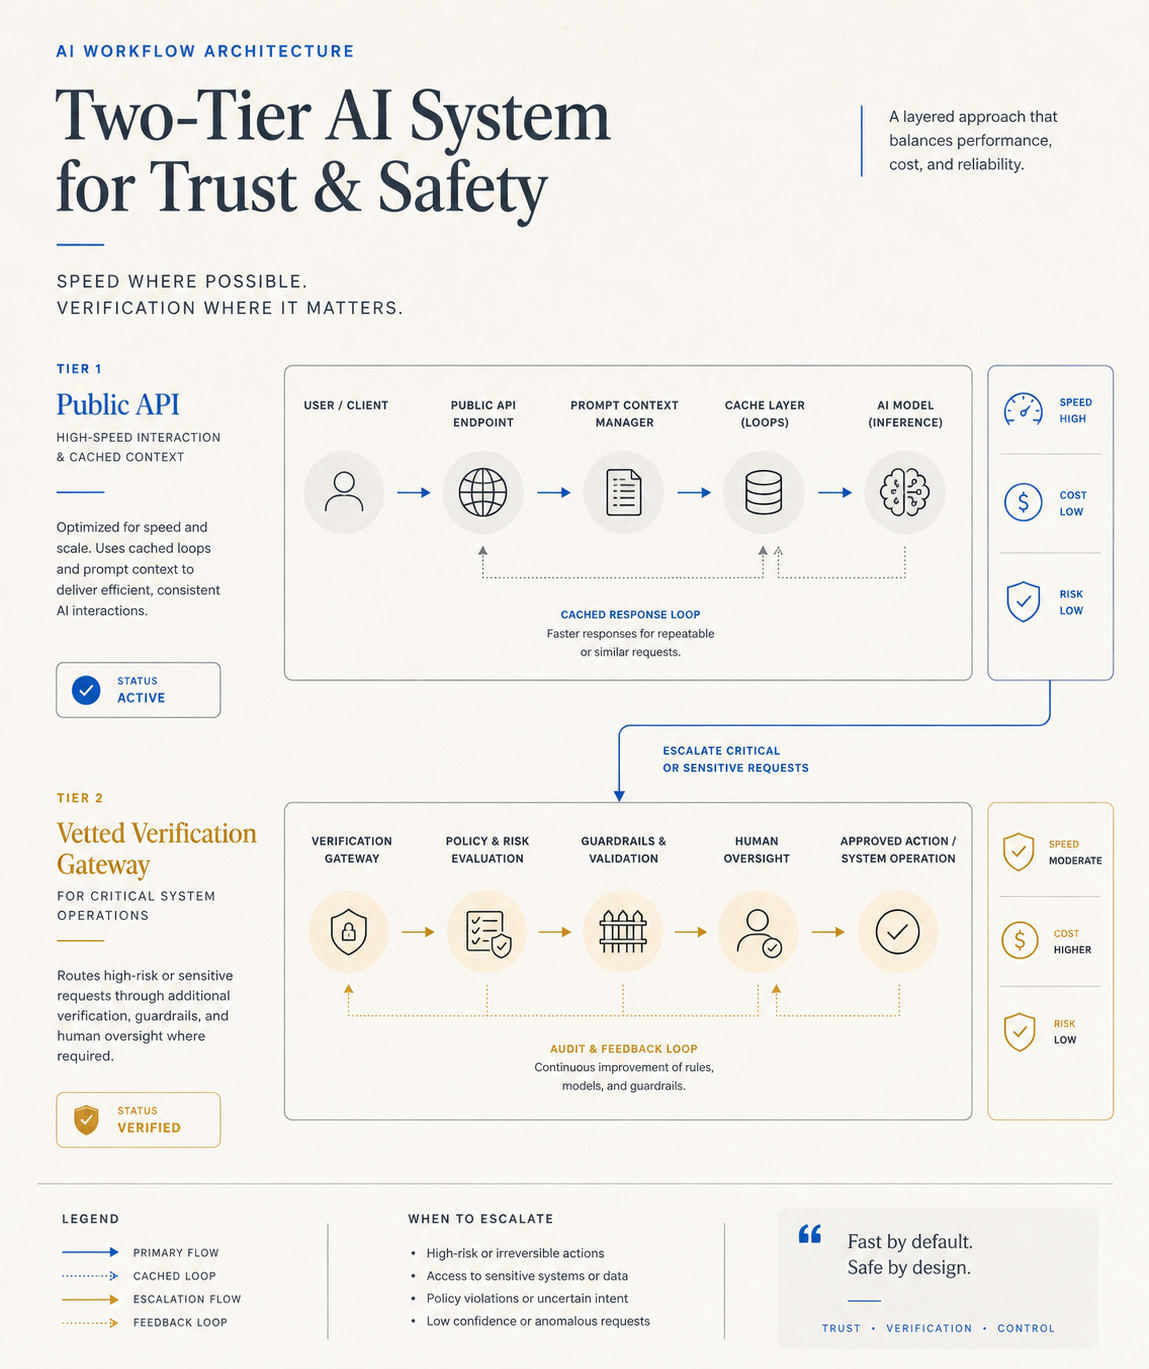
Ya no existe un único endpoint comercial para el nivel más alto de inteligencia. En su lugar, los proveedores han comenzado a bifurcar sus modelos: por un lado, una capa comercial abierta con salvaguardas estrictas y fuertes optimizaciones de coste; por otro, una versión idéntica en pesos pero desprovista de restricciones operativas, reservada exclusivamente para organizaciones verificadas bajo programas cerrados de acreditación.
Al mismo tiempo, la economía de los agentes autónomos ha dado su giro más drástico del año. Mientras los titulares se concentraron en las salvaguardas, un ajuste aparentemente menor en la lista de precios de Anthropic —un recorte del 75% en la lectura de contexto cacheado— ha dejado en evidencia dónde reside el verdadero coste de operar agentes en producción.
El auge del doble régimen: la inteligencia se separa del permiso
El 1 de septiembre, Anthropic lanzó simultáneamente Claude Fable 5.1 y Claude Mythos 5.1. Ambos modelos comparten exactamente los mismos pesos fundacionales y la misma arquitectura de razonamiento adaptativo con una ventana de contexto de 1 millón de tokens. Sin embargo, su destino operativo es radicalmente distinto:
- Claude Fable 5.1 está disponible de forma general en la API pública ($10 por millón de tokens de entrada y $50 por millón de salida), gobernado por capas de moderación automatizadas y restricciones de ejecución de código.
- Claude Mythos 5.1 no tiene precio público ni acceso abierto. Solo puede ejecutarse mediante programas de acceso verificado (como el Cyber Verification Program y Glasswing de Anthropic), limitados a unos 150 organismos gubernamentales, operadores de infraestructura crítica y equipos de ciberdefensa en 15 países.
La razón no es teórica: en entornos de ejecución de terminal y resolución de incidentes, Mythos 5.1 alcanza un 60.9% en el benchmark Terminal-Bench 4.0, frente al 55.8% de Fable 5.1, una brecha provocada exclusivamente por las intervenciones de las salvaguardas comerciales que bloquean al modelo cuando detecta comandos de bajo nivel en el sistema.
Apenas unas horas después, el patrón se confirmó en todo el sector:
- OpenAI anunció Astra, el primer modelo de su historia en activar el umbral «crítico» de ciberseguridad bajo su marco de preparación (Preparedness Framework). La compañía confirmó que retendrá su lanzamiento público general y limitará su disponibilidad a un grupo cerrado de defensores evaluados, citando capacidades autónomas de explotación y parcheo que superan las barreras defensivas actuales.
- Google DeepMind liberó Gemini 3.8 Flash, pero no lo hizo solo: presentó en paralelo Gemini 3.8 Flash Cyber, una variante con mitigaciones relajadas orientada a la ingeniería de sistemas, accesible únicamente mediante el nuevo programa Fairwind para gobiernos y mantenedores de plataformas centrales.
¿Por qué ocurre esto ahora? Porque los modelos han alcanzado el punto en el que el razonamiento general de alto nivel genera, de manera emergente, capacidades ofensivas y de manipulación de infraestructura. Como demostró la china Z.ai con su modelo de código abierto GLM-5.3 a finales de agosto, escalar el post-entrenamiento (post-training scaling) dota a los modelos de habilidades de descubrimiento de vulnerabilidades a una velocidad superior a la prevista. Cuando estas capacidades emergen en los pesos, los laboratorios comerciales no pueden simplemente eliminarlas sin degradar la inteligencia del modelo; la única alternativa es gobernar quién tiene la llave.
Para los directores de tecnología y líderes empresariales, la lección es directa: el acceso a la frontera de la IA ya no es un problema de presupuesto, sino de verificación institucional («Know Your Agent»). Si tu empresa planea delegar en agentes tareas críticas de ciberseguridad, gestión de redes o auditoría profunda de infraestructura, pronto descubrirá que las APIs comerciales estándar se negarán a ejecutar los comandos necesarios.
La revolución silenciosa del caché: el 75% que reconfigura el coste agéntico
Mientras el debate público se centraba en la seguridad, la verdadera noticia operativa para quienes construyen y despliegan agentes de IA llegó en la letra pequeña de la API de Anthropic: el precio de lectura de caché se redujo en un 75%, pasando de $1.00 a $0.25 por millón de tokens.
A primera vista, un descuento en tokens leídos parece incremental frente a la tarifa base de $10 / $50. Pero en la arquitectura de un agente de software real, las matemáticas son demoledoras:
Un agente autónomo no funciona como un chat de una sola interacción. En una sesión de trabajo de 25 o 30 turnos —donde el agente inspecciona un repositorio, consulta documentación, ejecuta comandos de terminal, analiza errores y vuelve a intentar una solución— el prompt del sistema, las definiciones de herramientas y el historial acumulado se reenvían en cada llamada.
En ese patrón:
* El 85% al 92% de los tokens consumidos en cada llamada son tokens de contexto previamente enviados que se recuperan de la memoria caché del proveedor.
* Con la tarifa anterior de $1.00 por millón, una sesión intensiva de resolución de incidencias consumía decenas de dólares en lecturas repetidas de contexto.
* Al bajar a $0.25 por millón (un 2.5% de la tarifa de entrada base en lugar del 10%), el ahorro neto para flujos agénticos alcanza entre un 35% y un 45% del coste total de la sesión, según los propios datos de telemetría de agosto reportados por Anthropic.
Este cambio altera la viabilidad financiera de proyectos que antes eran prohibitivos. Tareas de auditoría de código continuo, sincronización de bases de datos relacionales con lenguaje natural o agentes de soporte nivel 3 que mantienen expedientes masivos en memoria ahora pueden operar de forma continua sin disparar la factura mensual.
Las tres roturas de API que castigan el código descuidado
Sin embargo, el abaratamiento del cómputo agéntico viene acompañado de exigencias técnicas rigurosas. Con Fable 5.1, Anthropic ha introducido tres cambios de comportamiento en su API que obligan a auditar el código de los harnesses de agentes:
- Fin de la imposición forzada de herramientas (
tool_choice: "any"):
Enviartool_choice: "any"otool_choice: "tool"ahora devuelve un error HTTP 400 Bad Request. Los desarrolladores deben migrar inmediatamente atool_choice: "auto"con validación estructurada (strict: true) o dirigir el comportamiento mediante el prompt del sistema. Los agentes que dependían de obligar al modelo a llamar a una función en bucles rígidos fallarán en producción si no actualizan su integración. - Enlace unidireccional de bloques de pensamiento (Prefix Binding):
Los bloques de razonamiento interno (thinking blocks) ahora quedan vinculados de manera estricta al prefijo de la conversación. Si un harness intenta modificar o «limpiar» turnos anteriores, alterar el prompt del sistema o reordenar las herramientas a mitad de una sesión, la API invalidará los bloques de razonamiento posteriores. Para cuentas creadas a partir del 31 de agosto de 2026, esta restricción es estricta. - Pena máxima a la ruptura del caché:
Dado que el beneficio económico radica en pagar $0.25/Mtok en lugar de $10.00/Mtok, cualquier diseño que inserte marcas de tiempo dinámicas, identificadores aleatorios o cambios de contexto al inicio del prompt destruye el prefijo de caché. En 2026, un programador que no diseñe sus prompts con disciplina de inmutabilidad multiplicará el coste operativo de su empresa por cuarenta.
La dispersión de precios de 119x y el enrutamiento jerárquico
La semana cerró con otro dato elocuente revelado por los índices de Artificial Analysis: la dispersión de precios en los 15 principales modelos del mercado alcanzó un factor de 119 veces.
Mientras modelos de frontera como Claude Fable 5.1 alcanzan un coste combinado cercano a los $11.90 por millón de tokens en tareas complejas de razonamiento profundo, Meta liberó de forma silenciosa Muse Spark 1.3, con un precio combinado de apenas $0.10 por millón de tokens en su nivel de contribución y $1.25/$4.25 en su API comercial estándar.
Lo relevante de Muse Spark 1.3 no es solo su precio, sino su comportamiento: Meta lo optimizó específicamente para colaboración agéntica, logrando un 20% menos de llamadas a herramientas y un 25% menos de tokens consumidos que su predecesor, gracias a que el modelo ahora sabe cuándo pedir aclaraciones al usuario o detenerse a pedir confirmación antes de ejecutar una acción con efectos secundarios irreversibles.
Esta polarización del mercado exige abandonar la idea del «modelo único para toda la empresa». Las organizaciones que lideran en eficiencia operativa están implementando una arquitectura de enrutamiento jerárquico:
- Nivel 1 (Triage y orquestación rápida): Modelos ultraoptimizados y económicos (como Gemini 3.8 Flash a $0.75/$3.75 o Muse Spark 1.3) gestionan el filtrado inicial, la clasificación de tickets, la extracción de entidades y las consultas sencillas a APIs.
- Nivel 2 (Razonamiento profundo y ejecución crítica): Modelos de frontera adaptativa (como Claude Fable 5.1) entran en juego únicamente en los puntos de decisión donde se requiere planificar arquitecturas de software, resolver excepciones financieras complejas o sintetizar directrices regulatorias.
Decisiones prácticas para comités de tecnología y operaciones
Ante este nuevo panorama de doble régimen y reconfiguración de precios, las empresas deben adoptar cuatro medidas inmediatas:
- Auditar la arquitectura de contexto de sus agentes:
Revise cómo sus aplicaciones construyen las llamadas a la API. Asegúrese de que las partes estáticas (instrucciones del sistema, esquemas de OpenAPI, documentación de referencia) se coloquen rigurosamente al inicio para garantizar tasas de acierto de caché superiores al 85%. - Eliminar dependencias de
tool_choiceforzado:
Actualice los SDKs y harnesses para manejar la selección de herramientas de forma autónoma con esquemas estrictos (strict: true), evitando que llamadas deprecadas bloqueen flujos en producción. - Iniciar el mapeo de requisitos de verificación («Know Your Agent»):
Si su hoja de ruta incluye agentes autónomos para DevSecOps, administración de infraestructura en la nube o auditoría de seguridad interna, comience a documentar los casos de uso para postular a los programas de acceso confiable de los proveedores (Anthropic CVP, Google Fairwind) antes de que el acceso público se restrinja aún más. - Evaluar alternativas soberanas y abiertas para operaciones críticas:
Para empresas que no deseen depender del escrutinio de acceso de los proveedores estadounidenses, los avances en pesos abiertos (como los modelos MoE de la serie Tencent Hy4 o GLM-5.3 de Z.ai) demuestran que es viable desplegar capacidades agénticas avanzadas en infraestructura privada de computación.
Septiembre de 2026 marca el fin de la ingenuidad en el software empresarial asistido por IA: la frontera ya no se mide únicamente en parámetros o velocidad de generación, sino en la capacidad de navegar un ecosistema donde la inteligencia más potente exige confianza verificada y donde la eficiencia del caché define qué empresas pueden sostener sus agentes en producción y cuáles quedarán fuera de juego por costes.
Fuentes primarias y referencias de la industria
- Anthropic: Anuncio oficial de Claude Fable 5.1 y guía de migración en Anthropic Engineering y Claude API Documentation.
- Google DeepMind: Presentación de Gemini 3.8 Flash y programa Fairwind en Google The Keyword y DeepMind Research.
- OpenAI: Declaración sobre el modelo Astra y umbrales del Preparedness Framework en OpenAI Research.
- Digital Applied & Local AI Zone: Registros de lanzamientos, ledger de precios y análisis de benchmarks en Digital Applied Release Tracker y Local AI Zone September Dispatch.
- Artificial Analysis: Índices de coste por tarea y dispersión de precios en modelos de frontera (Artificial Analysis).