La privacidad de la IA suele descansar sobre una promesa: “los datos están protegidos”. El nuevo sistema de aprendizaje federado que Google Research presentó el 2 de octubre intenta convertir esa promesa en algo más incómodo y más útil: código, políticas y ejecución que terceros puedan inspeccionar.
El cambio no consiste en volver a entrenar modelos sin mover ningún dato. Los dispositivos siguen cifrando ejemplos de entrenamiento y enviándolos al servidor. La diferencia está en qué puede hacer el servidor con ellos, quién puede comprobarlo y qué parte del proceso queda fuera del alcance de los operadores.
La noticia: el entrenamiento federado entra en una caja verificable
En su artículo “Toward provably private learning from federated data”, Google Research describe un sistema de aprendizaje federado basado en Trusted Execution Environments (TEEs). El anuncio, firmado por Katharine Daly y Daniel Ramage, sostiene que la arquitectura ofrece garantías de privacidad verificables externamente y permite trasladar buena parte del cálculo al servidor.[1]
El sistema ya se ha utilizado para entrenar modelos de predicción de siguiente palabra en Gboard en inglés y japonés. Según Google, el nuevo enfoque mejora la precisión y acelera el entrenamiento frente a su infraestructura anterior, además de permitir garantías de privacidad más fuertes y auditables.[1]
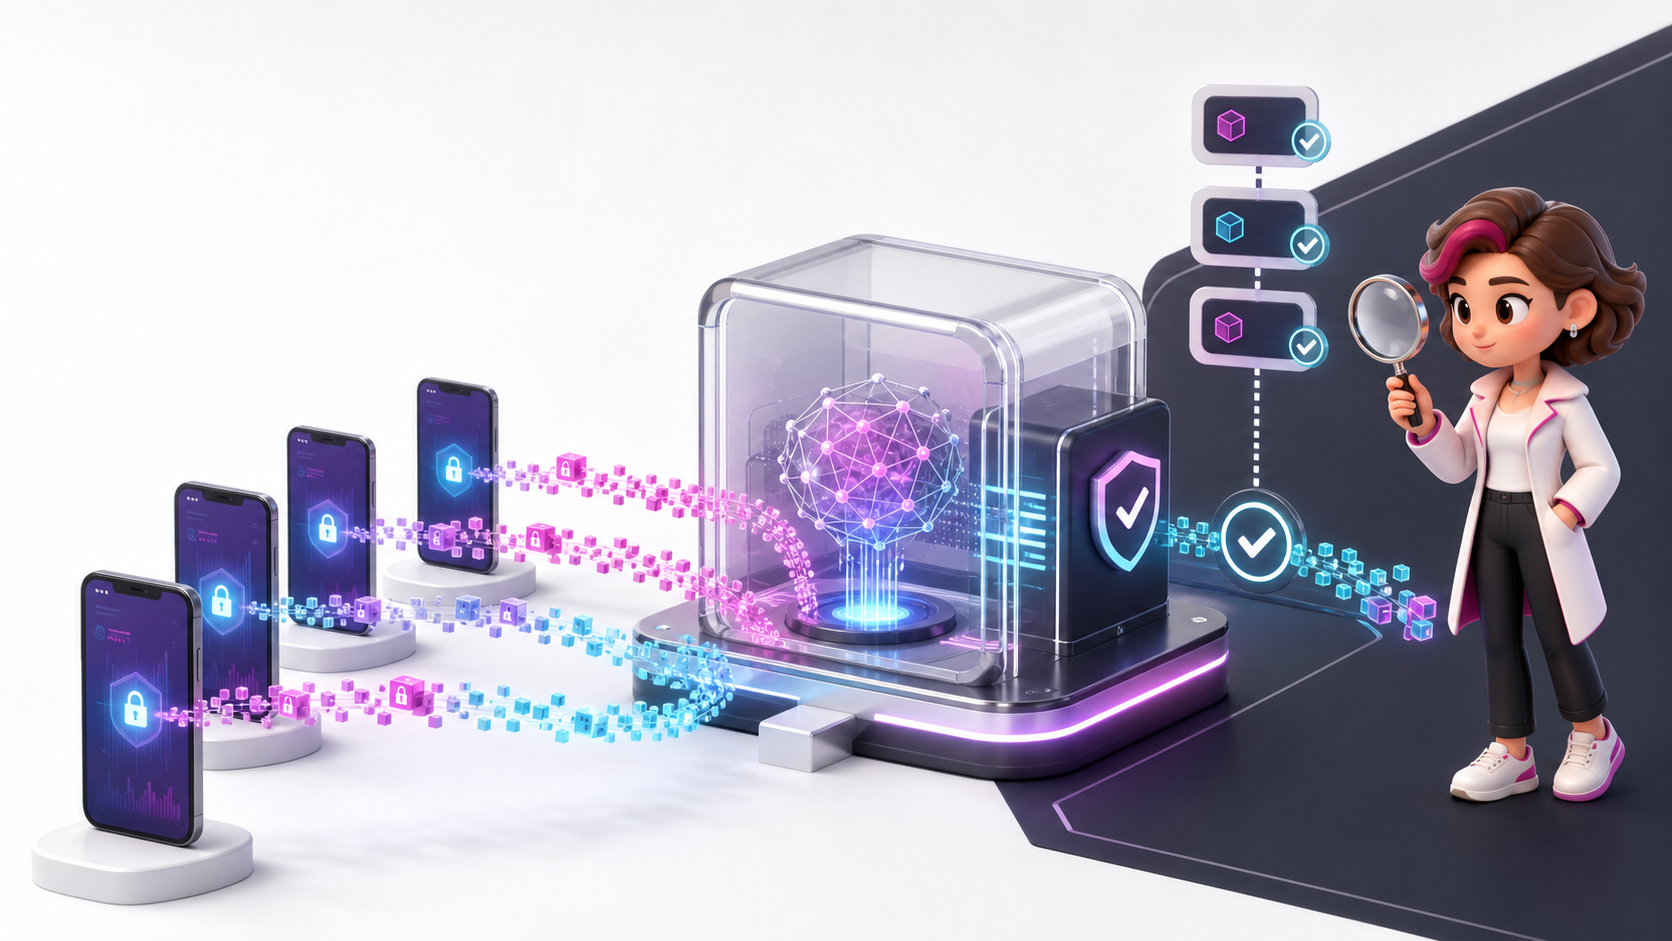
La diferencia está en la cadena de control:
- El dispositivo cifra los ejemplos antes de subirlos.
- Una política de acceso define qué programas futuros pueden procesar esos datos y exige que la política se publique en un registro de transparencia.
- Un servicio de gestión de claves dentro de TEEs solo entrega las claves a cargas de trabajo que coinciden con esa política.
- Un programa Python en un TEE ejecuta el entrenamiento y delega tareas paralelizables a otros entornos protegidos.
- El resultado visible para los operadores se limita a métricas y pesos de modelo con privacidad diferencial, no a los ejemplos individuales.
La arquitectura usa Rekor como registro público de transparencia para que auditores externos puedan observar las políticas que autorizan los posibles trabajos del servidor. El diseño también permite cargar en tiempo de ejecución componentes propietarios, como arquitecturas de modelos o lógica de preprocesamiento, sin sacar del programa la parte relevante para la privacidad.[1][2]
Qué resuelve frente al aprendizaje federado anterior
El aprendizaje federado nació para que varios dispositivos colaboraran en el entrenamiento sin entregar al coordinador sus datos brutos. En la práctica, el modelo de privacidad no depende solo de dónde se calcula un gradiente. También depende de qué software puede acceder a los datos, qué se registra, cuándo se liberan las claves y si alguien externo puede comprobar que el sistema ejecutó lo prometido.
Google identifica dos límites de sus sistemas anteriores. Primero, no existía una forma para que observadores externos verificaran que los datos subidos no se habían almacenado o inspeccionado. Después, la agregación segura protegió criptográficamente las cargas, pero no encajaba bien con las garantías de privacidad diferencial central más avanzadas.[1]
El nuevo sistema mueve el centro de gravedad. Los teléfonos ya no tienen que hacer todo el cálculo pesado ni coincidir en el mismo momento para que una ronda avance. Los datos pueden reunirse cifrados y el servidor puede elegir dentro del entorno protegido un calendario de participación que optimice la relación entre utilidad y privacidad.
El artículo académico reporta que esta organización mejora la cobertura de dispositivos y desplaza favorablemente las curvas de privacidad-utilidad. En el caso de Gboard, Google afirma que los modelos se entrenan más rápido y con mejor precisión bajo presupuestos de privacidad menores y ahora verificables externamente.[2]
Hay un dato operativo que ayuda a medir el cambio: Google dice que el entrenamiento de estos modelos podía tardar entre uno y dos meses en la infraestructura anterior, limitado por la disponibilidad de dispositivos, el cálculo local y la competencia entre cargas de trabajo. Con el nuevo diseño, el cuello de botella se desplaza al servidor y la ejecución se paraleliza entre muchas máquinas.[1]
La lectura de Olbrite: la confianza deja de ser una configuración interna
La tesis es concreta: en la IA que aprende de datos sensibles, la privacidad no debería ser solo una propiedad declarada por el proveedor; debe ser una propiedad que el sistema permita verificar.
Esto cambia la conversación empresarial. “Los datos no se usan para otra cosa” es una política. “Estas son las únicas cargas de trabajo autorizadas, este es el código que las ejecuta y este registro permite comprobarlo” es una superficie de auditoría.
La diferencia importa porque los proyectos de IA suelen mezclar tres planos distintos:
- Confidencialidad: quién puede leer el dato mientras se procesa.
- Integridad: qué código puede modificarlo o producir el modelo.
- Trazabilidad: qué evidencia queda para reconstruir lo que ocurrió.
Un TEE puede reforzar los dos primeros planos, pero el tercero exige políticas legibles, registros públicos o verificables y procesos que conecten una versión de código con una ejecución concreta. La privacidad deja de ser una casilla en una arquitectura y se parece más a una cadena de custodia técnica.
Por qué importa para empresas y equipos de datos
1. Los datos sensibles pueden alimentar modelos sin entregar el control al operador
Salud, banca, telecomunicaciones y dispositivos personales comparten un problema: el dato es valioso para mejorar el modelo, pero también es demasiado delicado para quedar a disposición de quien opera la infraestructura. La propuesta de Google no elimina la transferencia cifrada ni el riesgo de la computación confidencial, pero reduce el conjunto de programas que pueden descifrar y procesar los ejemplos.
Para una empresa, eso sugiere una pregunta más precisa que “¿el proveedor cumple privacidad?”: ¿puedo enumerar los trabajos que tienen permiso para tocar mis datos y comprobar que no se amplió ese permiso después?
2. La auditoría entra en el diseño del flujo, no al final
Si las políticas de acceso se publican antes de que los datos estén disponibles para el servidor, la revisión deja de ser una inspección retrospectiva de logs internos. Un auditor puede comparar la autorización declarada con los binarios y la ejecución atestada, dentro de los límites de la tecnología disponible.
Eso no convierte a un registro en una certificación automática. Sí permite diseñar controles de cambio: si cambia el programa, la política, la clave o el entorno de ejecución, el flujo puede exigir una nueva autorización antes de procesar datos.
3. La privacidad tiene un coste que ahora puede medirse junto a la utilidad
La privacidad diferencial añade ruido; la ejecución protegida añade complejidad; el cifrado y la coordinación añaden latencia. Una decisión empresarial madura no debe preguntar solo cuánta privacidad obtiene, sino qué precisión, cobertura, tiempo de entrenamiento y coste operativo conserva en cada nivel de protección.
El enfoque de Google es interesante porque permite optimizar la participación de dispositivos después de reunir las cargas cifradas. En lugar de aceptar pasivamente qué teléfonos estuvieron disponibles a una hora concreta, el sistema puede elegir un calendario que mejore la curva de privacidad-utilidad. Esa flexibilidad es una capacidad de operación, no solo un detalle criptográfico.
4. El servidor puede hacer más sin recuperar una posición de confianza total
Mover el entrenamiento al servidor suele parecer incompatible con la privacidad. La arquitectura de TEEs propone una tercera vía: usar la capacidad del servidor, pero limitarla mediante hardware, atestación remota, políticas y programas reproducibles.
La solución no es absoluta. Los TEEs actuales tienen limitaciones y pueden estar expuestos a problemas de canales laterales. La implementación también debe ser correcta: una política transparente no compensa un error en el código, una configuración defectuosa o un registro que nadie revise.
5. La ventaja competitiva puede estar en demostrar el control
En mercados regulados, poder mostrar cómo se protege un dato puede ser tan importante como mejorar unos puntos de precisión. Una empresa que conserva una evidencia verificable del linaje de sus modelos puede responder mejor a clientes, auditores y reguladores que otra que solo presenta una cláusula contractual.
La señal más valiosa del anuncio no es que Google use TEEs para Gboard. Es que el patrón puede extenderse a otras cargas expresadas en Python, como generación de datos sintéticos, evaluación de modelos o inferencia especializada. Cada nuevo caso tendrá que demostrar que el beneficio compensa su superficie de ataque y su coste operativo.
Qué hacer esta semana
- Dibuja el mapa de acceso real. Para un conjunto de datos sensible, registra qué dispositivo lo produce, cómo se cifra, qué servicios lo reciben, qué claves intervienen y qué programas pueden procesarlo.
- Separa la promesa de la evidencia. Pide al proveedor una descripción de la política, el mecanismo de atestación, la retención de datos, los registros de transparencia y el procedimiento de cambio de software.
- Elige un piloto de bajo riesgo. Empieza con una tarea de predicción o clasificación donde los datos estén minimizados y el resultado pueda compararse con un proceso existente. No uses el primer piloto para automatizar una decisión irreversible.
- Mide cuatro curvas. Registra privacidad, precisión, cobertura de dispositivos y coste/latencia. Una arquitectura protegida que no puede operar dentro de los límites del negocio no está lista para producción.
- Define el “no verificable”. Decide qué ocurre si falla la atestación, cambia el binario, desaparece el registro público o un resultado no puede vincularse a una política. La ausencia de evidencia debe detener o escalar el flujo, no convertirse silenciosamente en aprobación.
Qué observar antes de llamarlo prueba definitiva
El trabajo es una implementación de producción en Gboard y un paso relevante hacia la computación federada auditable, pero no es una prueba matemática de que toda la privacidad quede resuelta. La seguridad depende de los TEEs, del KMS, del registro, de los binarios reproducibles y de que el código de privacidad sea correcto. Google reconoce que quedan límites en el hardware actual y que los canales laterales siguen siendo un área abierta de investigación.[1]
También conviene no confundir “el servidor no puede inspeccionar los ejemplos durante el flujo autorizado” con “ningún dato sensible abandona el dispositivo”. Los datos se cifran, se suben y se procesan dentro de una infraestructura concreta. La pregunta empresarial sigue siendo quién controla las claves, qué política autoriza el descifrado, cuánto dura el acceso y qué evidencia queda.
La siguiente señal será la interoperabilidad. Si cada proveedor define sus propias políticas, registros y mecanismos de atestación, la auditoría quedará encerrada en cada nube. Si aparecen formatos comunes y verificadores independientes, la privacidad pasará de ser una afirmación de arquitectura a una propiedad que pueda comprobarse entre organizaciones.
La continuidad editorial de Olbrite
Este artículo continúa la línea de SynthID Bio: la IA diseña proteínas y empieza a dejar rastro. Allí analizamos cómo una señal de procedencia puede acompañar a un diseño biológico generado por IA; aquí la procedencia se aplica al proceso que entrena el modelo. En ambos casos, el activo no solo debe funcionar: también debe poder explicar de dónde salió y bajo qué controles.
También conecta con La IA de septiembre cambia de carrera: menos modelo único, más sistema gobernado. La arquitectura federada de Google refuerza esa misma lectura: el valor no está únicamente en el modelo, sino en el sistema de permisos, ejecución, evaluación y auditoría que lo rodea.
La privacidad útil es una propiedad que admite preguntas
El aprendizaje federado empezó con una intuición poderosa: un modelo puede aprender de muchos dispositivos sin llevarse sus datos a un repositorio central legible. El paso que ahora importa es más exigente: que el servidor tampoco tenga que pedir fe ciega sobre lo que hace con la información cifrada.
La confianza digital no desaparece porque haya un TEE. Cambia de lugar. Pasa a la política que autoriza el trabajo, al código que puede ser inspeccionado, a la clave que solo se libera bajo ciertas condiciones y al registro que permite a otro hacer preguntas.
Para la empresa que evalúa IA con datos sensibles, esa es la decisión práctica: no preguntar solo “¿puedo usar estos datos?”, sino “¿puedo demostrar, antes y después, qué pudo hacer el sistema con ellos?”. Cuando la respuesta sea verificable, la privacidad dejará de ser una promesa comercial y empezará a comportarse como una capacidad operativa.
Fuentes consultadas
- Google Research — Toward provably private learning from federated data (2 de octubre de 2026). Anuncio primario sobre el sistema TEE, Gboard, políticas, transparencia y resultados operativos.
- Daly et al. — Toward provably private learning from federated data, arXiv:2609.31494 (versión 4, 30 de septiembre de 2026). Artículo técnico primario sobre diseño, garantías, privacidad-utilidad y evaluación.