Una defensa que aprende después del despliegue
Un detector de texto generado por IA puede funcionar bien con ejemplos conocidos y fallar cuando aparecen un modelo nuevo o un texto deliberadamente humanizado. Un estudio de MIT y Cornell propone una salida distinta: adaptar el detector con datos recientes y sin etiquetas durante la inferencia. El resultado mejora en escenarios adversariales, pero también deja una advertencia para cualquier sistema que cambie mientras está en producción.
El problema no es solo detectar: es detectar un objetivo que se mueve
Los detectores suelen entrenarse con una frontera relativamente estable: textos que se conocen como humanos frente a textos producidos por modelos concretos. En producción, esa frontera se desplaza. Cambian los modelos, cambian los hábitos de escritura y aparecen herramientas que reescriben un texto para esquivar la clasificación.
La investigación de Kevin Ren, de Cornell Tech, Manish Raghavan, del MIT, y Nikhil Garg, de Cornell Tech, parte de ese desajuste. Su trabajo, presentado por MIT News el 18 de noviembre de 2026 y publicado como el artículo Hitting a Moving Target: Test-Time Adaptation for AI Text Detection under Continual Distribution Shift, estudia cómo actualizar el detector con muestras nuevas no etiquetadas mientras opera.
El reto tiene una consecuencia práctica: un sistema que permanece congelado puede confundir una variación normal del lenguaje con una señal de generación automática, o dejar de reconocer un texto producido por un modelo que no estaba en sus datos de entrenamiento.
Qué cambia con la adaptación en tiempo de prueba
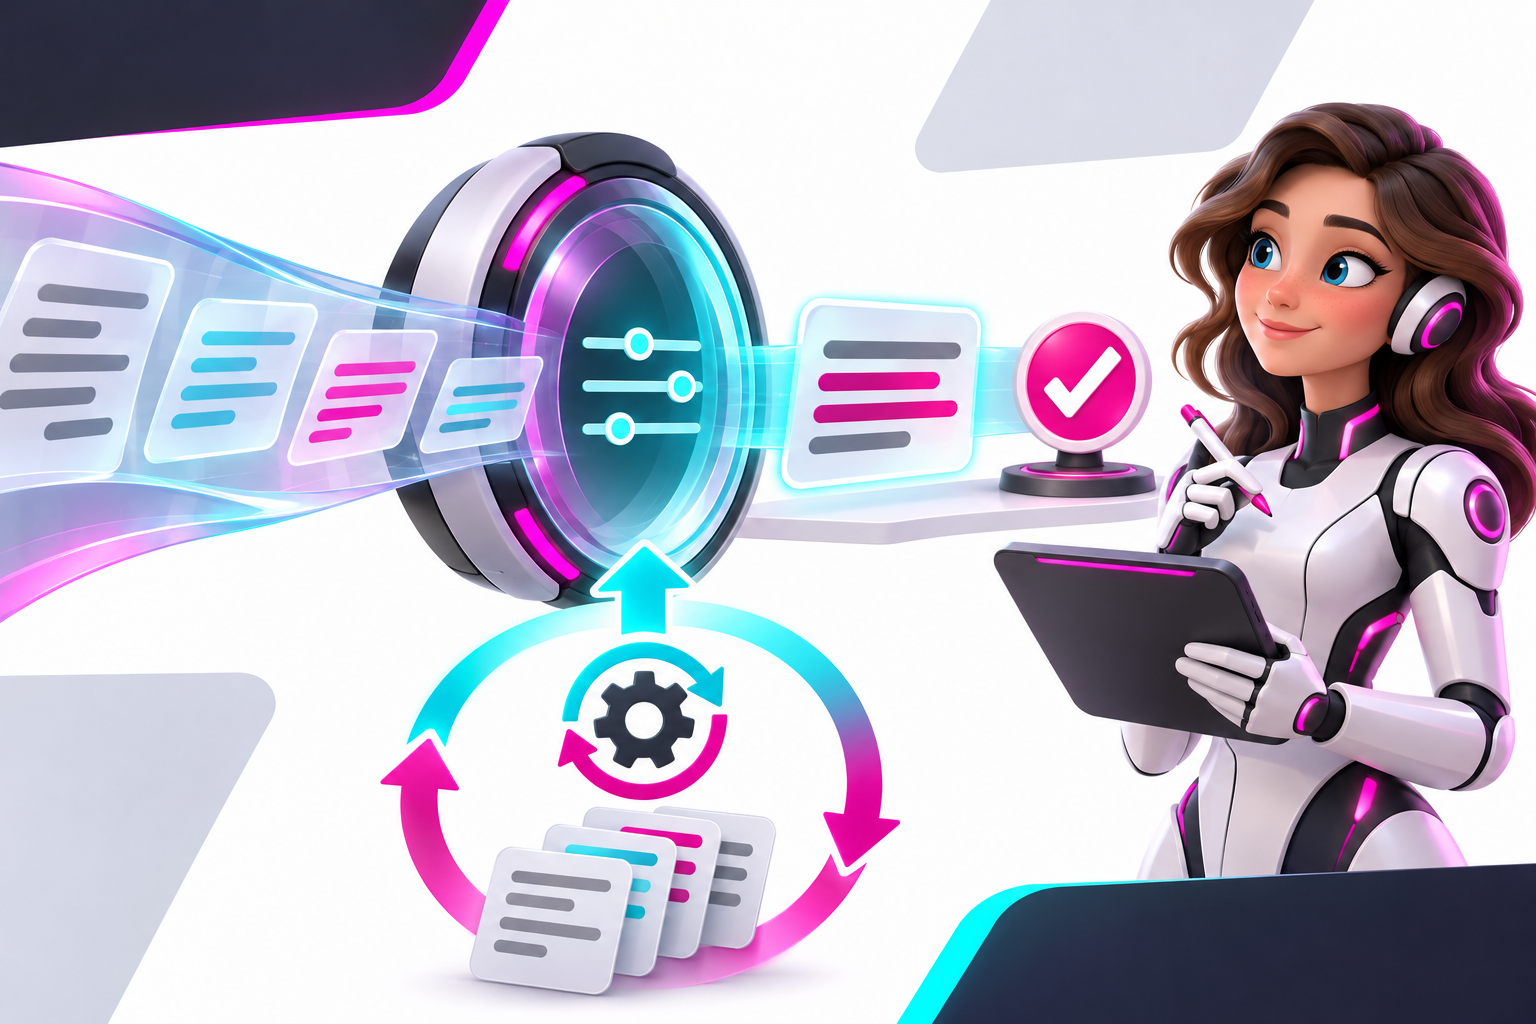
La técnica recibe el nombre de test-time adaptation (TTA). En vez de esperar a reunir un nuevo conjunto de datos etiquetado y reentrenar desde cero, el detector observa lotes recientes de texto sin etiqueta y ajusta su comportamiento para capturar la distribución que está encontrando.
En el trabajo, los investigadores explotan una propiedad concreta: cuando varios textos pasan por un sistema en un periodo corto, pueden compartir señales de haber sido producidos por un mismo modelo o flujo de generación. El método combina esa homogeneidad de las muestras con aprendizaje semi-supervisado y clasificadores positivos-no etiquetados. No equivale a “dejar que el detector crea cualquier cosa”: la adaptación forma parte del procedimiento experimental y debe medirse contra datos cuya respuesta real sí se conoce.
La diferencia es importante. El modelo ya no se evalúa solo por su rendimiento en una prueba fija, sino por su capacidad de mantenerse útil cuando el contexto cambia.
Los resultados son fuertes, pero acotados
En los experimentos descritos por MIT News, un detector comercial identificó aproximadamente el 27 % del texto generado por IA que había sido disfrazado para parecer humano. El enfoque con adaptación en tiempo de prueba alcanzó más del 93 % en ese escenario. En una prueba que simulaba cambios naturales en el lenguaje a lo largo del tiempo, el detector adaptativo obtuvo un 85 % de precisión frente al 73 % de los métodos tradicionales.
El artículo académico matiza la lectura. Los resultados proceden de experimentos controlados sobre cambios de distribución, no de una garantía universal para cada idioma, dominio o tipo de documento. Los autores advierten que la adaptación no es una solución definitiva: si la escritura humana y la generada se vuelven demasiado parecidas, puede ser más difícil conseguir ejemplos humanos verificables y separar las señales.
Por eso conviene leer las cifras como evidencia de que la estrategia merece evaluación, no como una licencia para convertir un porcentaje en veredicto automático.
La tesis de Olbrite: el producto es el bucle de evaluación
La noticia no anuncia simplemente un detector más preciso. Cambia la unidad de valor. En sistemas expuestos a adversarios o a cambios rápidos, la capacidad de actualizar el modelo con seguridad puede importar tanto como la arquitectura inicial.
Ese patrón aparece también fuera de la detección de texto. Un sistema antifraude encuentra nuevas tácticas. Un clasificador de calidad recibe productos de una temporada distinta. Un motor que prioriza incidencias ve cómo cambian los usuarios, las reglas y los canales. En todos esos casos, el modelo que gana una prueba de laboratorio puede perder vigencia al llegar al flujo real.
Pero adaptar no significa mutar sin control. Un detector que cambia con cada lote necesita límites, trazabilidad y una forma de volver a una versión anterior. De lo contrario, la mejora contra una clase de ataques puede crear falsos positivos en otra población.
Qué significa para una empresa
Operaciones: medir el cambio antes de automatizar la respuesta
Un equipo que use un detector para revisar documentos debe registrar cómo cambia su distribución de entradas: longitud, idioma, dominio, modelo sospechado, canal y tipo de usuario. Sin esa serie temporal, una caída de precisión puede parecer un problema del modelo cuando en realidad es un cambio de población.
Personas y confianza: una señal no es una prueba de autoría
Una clasificación probabilística no debería convertirse por sí sola en una sanción académica, editorial o laboral. El falso positivo puede dañar a quien escribió el texto; el falso negativo puede dejar pasar contenido no declarado. La salida responsable es combinar la señal con revisión humana, historial de versiones, fuentes y contexto del proceso.
Producto: diseñar una ruta de escalamiento
Si el detector encuentra una distribución que no reconoce, debe poder abstenerse, pedir más evidencia o derivar el caso. Un “no sé” controlado vale más que una etiqueta precisa en apariencia y equivocada en el momento importante.
Riesgo: proteger el conjunto de adaptación
Los datos sin etiqueta no son automáticamente inocuos. Si el sistema aprende de entradas manipuladas, un actor podría intentar mover su comportamiento. La adaptación requiere ventanas, controles de contaminación, límites de actualización, separación entre entrenamiento operativo y evaluación, y auditoría de los cambios.
Costes: comparar el ciclo completo
El ahorro de no reentrenar desde cero puede perderse si la adaptación exige más cómputo, almacenamiento, revisión o investigación de incidentes. La métrica útil no es solo la precisión: es el coste de una decisión correcta, una revisión humana y un error que llega al cliente.
Qué puede hacer un equipo esta semana
- Definir la decisión real. Especificar qué se hará con una señal del detector y qué decisiones quedan fuera de su alcance.
- Construir una línea base temporal. Guardar muestras representativas por fecha, canal, idioma y tipo de documento, con controles de privacidad.
- Probar el peor caso. Evaluar modelos nuevos, reescrituras, cambios de dominio y textos humanos recientes; medir falsos positivos y falsos negativos por grupo.
- Separar adaptación y aprobación. Permitir actualizaciones solo con umbrales, revisión y registro de quién autorizó el cambio.
- Crear un modo de abstención. Cuando la distribución se aparte demasiado de la referencia, derivar el caso a una persona en lugar de forzar una etiqueta.
Qué observar a partir de ahora
La siguiente pregunta no es si los detectores pueden mejorar en un conjunto de pruebas. Es si pueden adaptarse sin perder calibración, trazabilidad y equidad en un flujo que cambia todos los días.
Conviene observar cinco señales: cómo se comportan frente a modelos que no vieron durante el entrenamiento; si el rendimiento se mantiene en idiomas y dominios distintos; cuánto tarda la adaptación; qué ocurre cuando el lote está sesgado; y si el sistema puede explicar qué cambió entre dos versiones.
También hay un límite de fondo. Detectar el origen de un texto no demuestra que sea falso, dañino o de baja calidad. Para decisiones editoriales, educativas y empresariales, la verificación de afirmaciones, la procedencia y la calidad deben seguir siendo objetivos independientes.
Continuidad editorial de Olbrite
Esta investigación complementa el artículo de Olbrite sobre la medición de la confianza en sistemas de IA: ambos apuntan a la necesidad de protocolos repetibles, no promesas estáticas. También conecta con la trazabilidad como parte del producto de IA, porque un sistema que se adapta debe dejar evidencia de cuándo y por qué cambió.
La lección es sencilla y poco cómoda: un detector no se vuelve confiable por aprender una vez. Se vuelve confiable cuando puede cambiar con el mundo sin dejar de demostrar cómo, cuándo y con qué límites cambió.