La ventaja competitiva de un modelo de frontera ya no se mide solo por su capacidad de razonar. Para las empresas que trabajan con propiedad intelectual sensible, también cuenta una pregunta menos vistosa: ¿qué ocurre con los datos cuando el modelo entra en la operación?
Un reporte publicado el 14 de septiembre por Reuters, a partir de una información de The Information, apunta a una respuesta cada vez más contundente: algunas compañías están limitando el uso de modelos avanzados de Anthropic y OpenAI por dudas sobre el tratamiento de datos y la propiedad intelectual. El movimiento no anuncia el fin de la IA en la empresa; anuncia el fin de la confianza implícita.
La señal que llega desde Palantir, Nvidia y Booz Allen
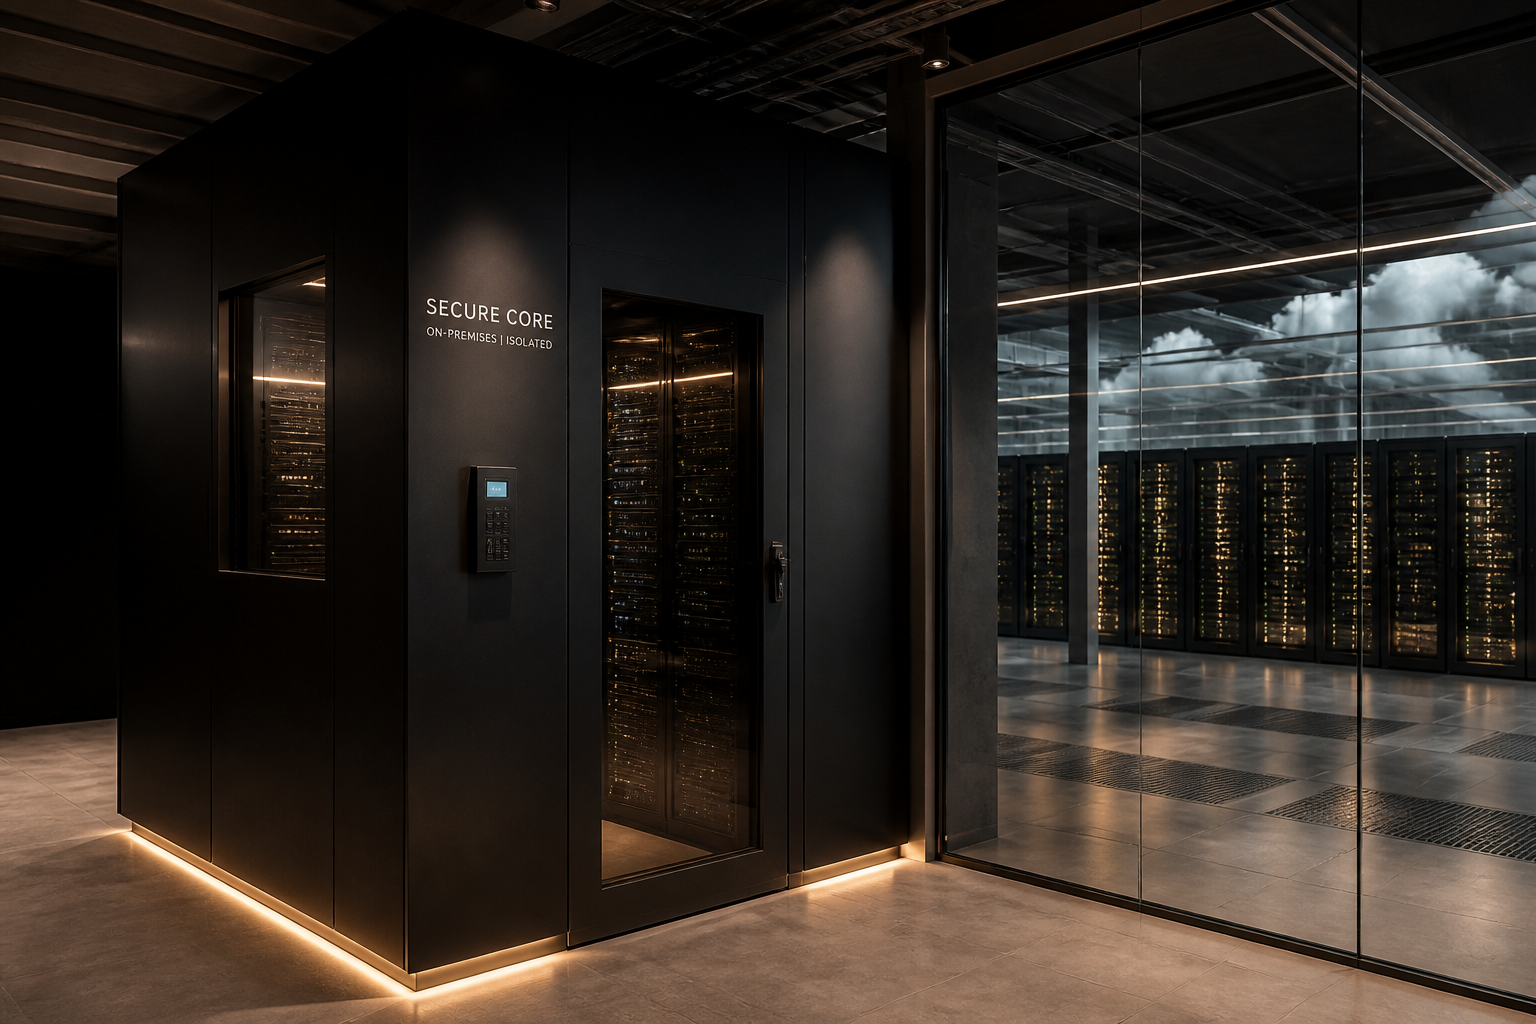
Según Reuters, Palantir habría presionado a Anthropic para obtener garantías irrevocables de retención cero antes de ofrecer sus modelos dentro del software de Palantir. Nvidia, por su parte, limitaría el uso de Anthropic a tareas menos sensibles y emplearía modelos propios Nemotron para trabajo interno. Booz Allen Hamilton habría prohibido el modelo comercial de Anthropic en tareas de ciberseguridad que involucren información propietaria.
Es importante separar el hecho de la interpretación. El artículo de Reuters presenta estas medidas como información atribuida a The Information y señala que las empresas mencionadas no respondieron de inmediato a sus solicitudes de comentarios. Anthropic y OpenAI sostienen que, por defecto, no entrenan sus modelos con datos de clientes salvo autorización; el reporte también menciona la recopilación de metadatos anonimizados para mejorar los productos. Eso no equivale a una garantía de riesgo cero: una empresa puede aceptar que sus datos no se usen para entrenamiento y, aun así, exigir controles sobre registros, proveedores, jurisdicción, acceso administrativo y propiedad intelectual.
El cambio operativo: de elegir un modelo a diseñar un perímetro
Durante la primera ola de adopción, muchas compañías comparaban modelos por calidad, precio por token y velocidad. Ese tablero queda incompleto cuando un agente puede leer documentos internos, escribir código, consultar sistemas de registro o ejecutar acciones.
La nueva decisión de arquitectura tiene al menos cuatro capas:
- Clasificación: qué datos pueden viajar a una API externa y cuáles deben permanecer en una red controlada.
- Retención: cuánto tiempo se guardan prompts, respuestas, archivos y trazas de herramientas, y quién puede acceder a ellos.
- Propiedad intelectual: qué ocurre con código, diseños, contratos, estrategias y otros activos que el modelo procesa o genera.
- Portabilidad: cómo cambiar de proveedor sin rehacer todos los flujos cuando cambian los términos, los precios o las capacidades.
La consecuencia práctica es que la estrategia de IA deja de ser una lista de licencias. Se convierte en una combinación de modelos, políticas, conectores, controles de identidad, registro de eventos y rutas de despliegue. En sectores regulados, “usar el modelo más inteligente” puede ser menos importante que demostrar dónde estuvo cada dato.
Por qué esto importa para el presupuesto y la productividad
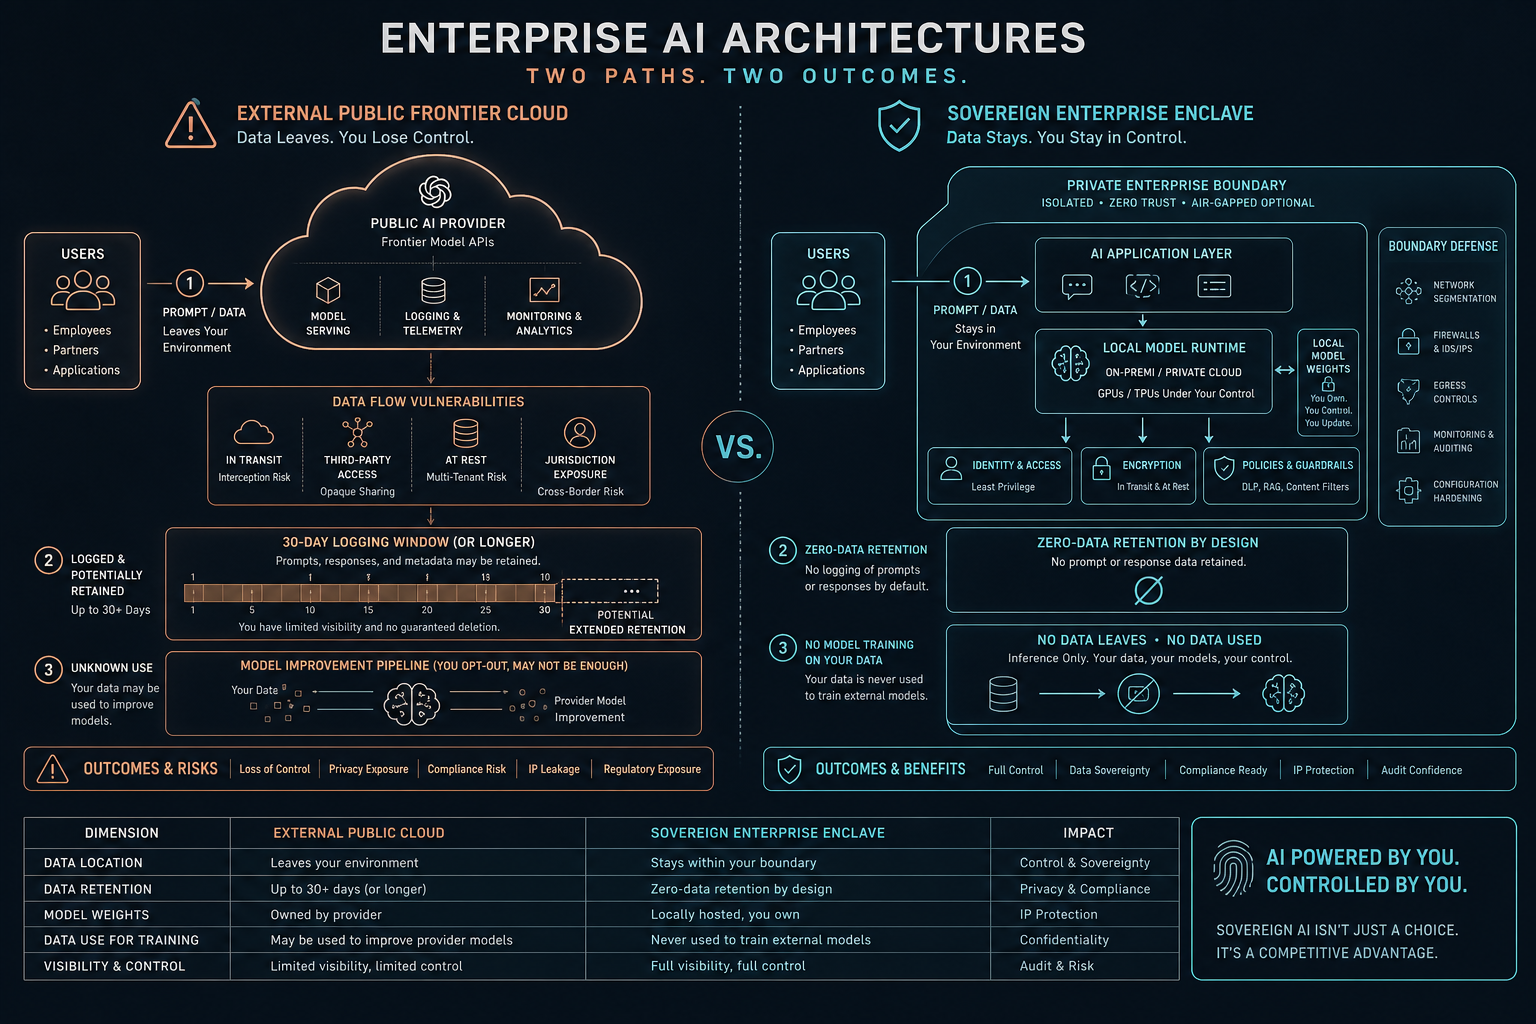
Una política de retención cero o un entorno aislado puede encarecer la implementación inicial. También puede reducir opciones de modelo, añadir trabajo de integración y exigir modelos propios o open-weight. Pero el coste debe compararse con el precio de una filtración, una disputa sobre propiedad intelectual o una auditoría que no pueda reconstruir qué hizo un agente.
La productividad tampoco desaparece: cambia de lugar. Las empresas pueden reservar modelos de frontera para información no sensible y tareas de alto valor, mientras despliegan modelos controlables para clasificación, extracción, búsqueda interna o automatizaciones repetitivas. La arquitectura híbrida evita que cada empleado tenga que decidir por intuición qué puede pegar en una ventana de chat.
Este enfoque también corrige una tentación frecuente: comprar acceso generalizado y medir éxito por consumo. Como mostró el caso de la infraestructura de agentes de OpenAI, la fiabilidad del arnés y de las herramientas puede tener más impacto que cambiar de modelo cada semana. Y, como vimos en el doble régimen de acceso de los modelos, la disponibilidad de la capacidad avanzada también se está convirtiendo en una variable económica y operativa.
Qué debería hacer una empresa esta semana
- Inventariar los flujos: documentar qué agentes y copilotos procesan secretos comerciales, datos personales, código o información regulada.
- Asignar niveles de riesgo: separar asistencia de bajo impacto de acciones que escriben en un ERP, CRM, repositorio o sistema de pagos.
- Negociar garantías verificables: pedir retención, entrenamiento, subprocesadores, ubicación, auditoría y borrado en términos contractuales, no solo en una página de marketing.
- Diseñar una ruta alternativa: probar un modelo local, un modelo open-weight o un proveedor secundario para los casos que no pueden depender de una sola política.
- Registrar el comportamiento: conservar trazas suficientes para investigar incidentes sin convertir el registro en un nuevo repositorio de datos sensibles.
La gobernanza que funciona durante la ejecución debe estar conectada al endpoint, a los permisos y a cada llamada de herramienta. Un documento que prohíbe enviar datos sensibles no detiene a un agente; una política aplicada por el gateway sí puede hacerlo.
La frontera real ya no es solo el modelo
La presión de Palantir, Nvidia y Booz Allen no demuestra que los modelos comerciales sean inseguros por definición. Sí demuestra que la promesa “no entrenamos con tus datos” ya no cubre todas las preguntas que una empresa debe responder. Retención, metadatos, jurisdicción, permisos y propiedad intelectual forman parte del producto.
El próximo estándar empresarial será menos espectacular que una nueva puntuación de benchmark: saber qué modelo puede tocar qué dato, con qué autorización y durante cuánto tiempo. Las compañías que construyan ese perímetro podrán usar la inteligencia de frontera sin entregar el control operativo a una caja negra.