La memoria de un modelo también necesita dormir
Google Research presenta un marco de aprendizaje continuo que alterna una fase activa con una pausa de consolidación. La idea no es que el modelo “recuerde” como una persona, sino que convierta parte de su contexto temporal en conocimiento más estable sin pagar cada actualización con olvido catastrófico.
Un modelo de lenguaje puede responder con información nueva mientras la tiene delante. El problema aparece después: cuando termina la sesión, ese contexto desaparece; cuando se actualizan sus parámetros de forma repetida, puede aprender lo nuevo y degradar lo anterior. Google Research puso ese dilema sobre la mesa el 27 de octubre con “The sleep framework: A new way for LLMs to retain knowledge in continual learning”, firmado por Ali Behrouz y Vahab Mirrokni.
La tesis de esta propuesta es sencilla de explicar y difícil de ejecutar: un modelo que aprende continuamente necesita dos ritmos. Uno para interactuar y acumular experiencias; otro, offline, para consolidarlas, depurarlas y preparar el siguiente ciclo.
Qué presentó Google Research
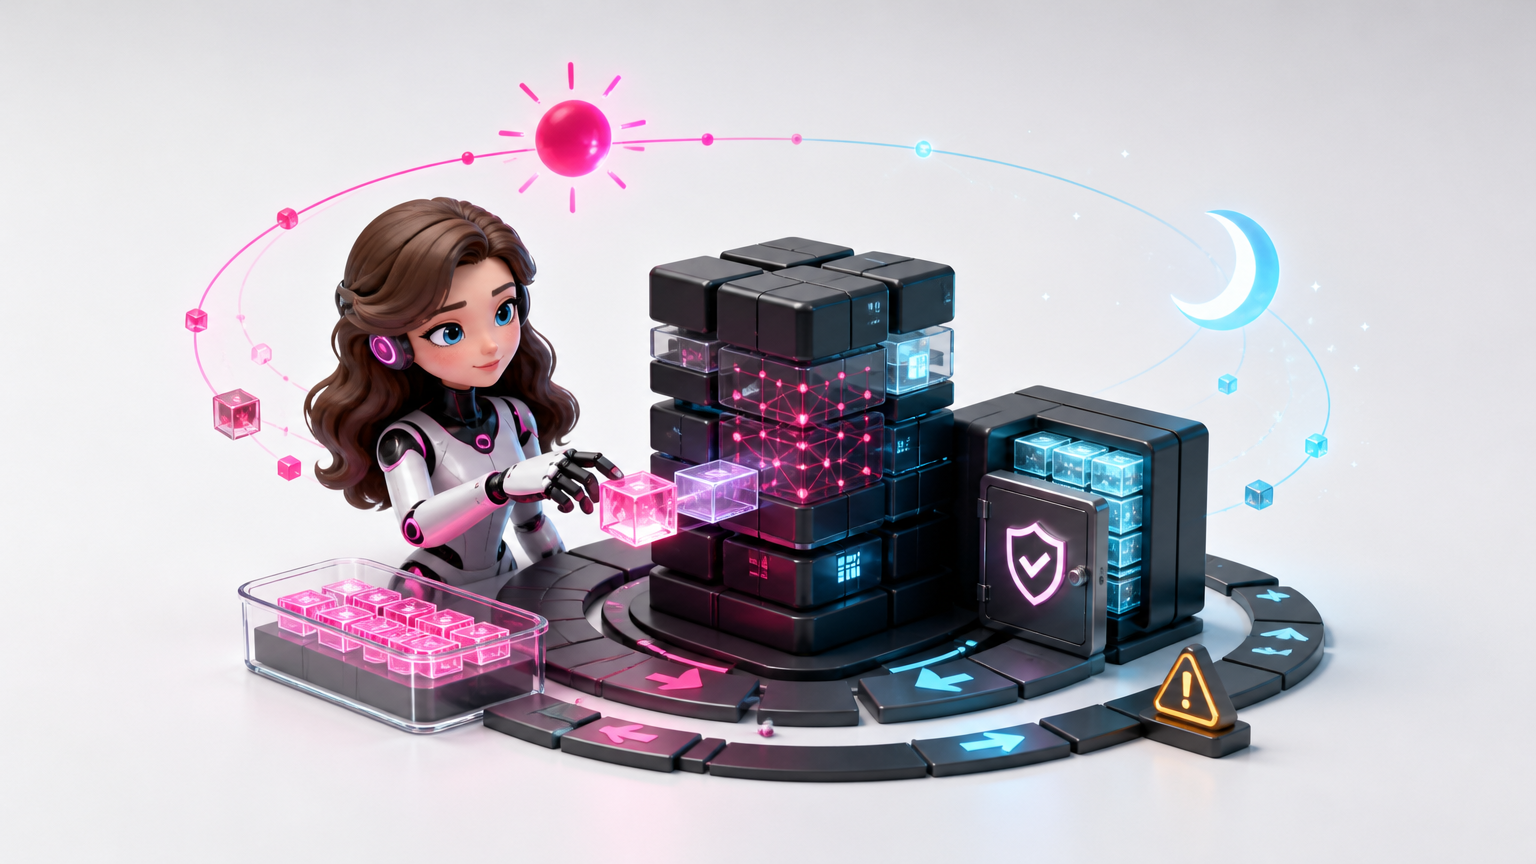
El marco describe un ciclo periódico con dos estados:
- Vigilia o fase activa: el modelo recibe entradas, interactúa y guarda información en componentes de memoria de corto plazo.
- Sueño o fase offline: el sistema deja de procesar nuevas entradas y dedica cómputo a consolidar memoria y mejorar capacidades.
La metáfora biológica tiene un límite importante: los autores aclaran que el procedimiento opera con arquitectura fija y reglas de entrenamiento definidas por humanos. No es una máquina que se reprograma libremente mientras duerme.
Durante la consolidación, el enfoque combina una ampliación de capacidad basada en bloques de expertos de bajo rango con una transferencia de conocimiento desde memorias frágiles de corto plazo hacia parámetros más estables. El proceso incluye destilación on-policy, aprendizaje por imitación con señales semánticas y un reinicio de los parámetros temporales una vez que la información relevante se ha asentado.
La segunda parte es el “dreaming”: una etapa de auto-mejora que activa expertos no habituales, genera ejemplos sintéticos, filtra los que contienen más señal de aprendizaje y refina el modelo con esos datos. La palabra es atractiva; el mecanismo es bastante menos mágico: selección, entrenamiento y evaluación bajo un ciclo controlado.
La evidencia: prometedora, pero no es un producto listo
Google Research informa resultados en aprendizaje incremental, traducción continua, incorporación de hechos, comprensión de contexto largo y razonamiento matemático. En su publicación, el marco mantiene una caída cercana a cero en evaluaciones de traducción continua para idiomas no vistos, escala el benchmark BABILong hasta 10 millones de tokens y alcanza 48,9 % en una evaluación de incorporación factual de tarea única y 46,2 % en preentrenamiento continuo.
En razonamiento matemático, el modelo base con sueño obtiene 79,2 % en AIME 2024, 69,0 % en AIME 2025 y 46,1 % en HMMT 2025, según la tabla comparativa que acompaña al artículo de Google Research.
Estos números deben leerse con precisión. Son resultados de investigación reportados por el equipo que propone el método; no equivalen a una garantía de que cualquier modelo empresarial pueda incorporar conocimiento sin degradarse. Tampoco prueban que el sistema sea autónomo en el sentido comercial de la palabra. Hacen algo más acotado y valioso: muestran una vía experimental para separar la adquisición temporal de la consolidación paramétrica.
El trabajo enlazado por Google Research es “Language Models Need Sleep: Learning to Self-Modify and Consolidate Memories”, de los mismos autores, disponible en arXiv con la versión 2 revisada el 10 de julio de 2026. Ese paper formula la idea de Knowledge Seeding y el ciclo de Dreaming; la publicación del 27 de octubre funciona como explicación y actualización editorial de la propuesta.
La lectura Olbrite: el cuello de botella cambia de sitio
Durante años, la conversación empresarial sobre modelos se concentró en la ventana de contexto: cuánto documento cabe, cuánto cuesta procesarlo y qué ocurre cuando la sesión termina. El marco de Google apunta a otro cuello de botella: cómo una organización actualiza el comportamiento de un modelo sin convertir cada cambio en una operación de reentrenamiento costosa o en una fuente de regresiones invisibles.
Eso importa para una empresa por cinco razones.
1. Los datos recientes pueden tener una ruta de aprendizaje más explícita
Un sistema que separa interacción y consolidación puede distinguir entre algo que el modelo debe usar ahora y algo que merece pasar a memoria más estable. Esa separación es útil para políticas de retención, revisión y caducidad.
2. El olvido deja de ser un detalle académico
Actualizar un sistema con nuevos procedimientos, productos o normativas puede romper respuestas que antes funcionaban. El valor empresarial no está en “aprender siempre”, sino en poder medir qué se incorporó, qué se preservó y qué se degradó después del ciclo.
3. El cómputo nocturno se vuelve una decisión operativa
Una fase offline necesita presupuesto, ventanas de ejecución, evaluación y controles de reversión. El modelo no duerme gratis: consume infraestructura y puede generar cambios difíciles de auditar si nadie define el perímetro.
4. La memoria debe tener gobierno, no solo capacidad
Que una información pueda consolidarse no significa que deba hacerlo. Datos personales, instrucciones temporales, secretos comerciales y hechos no verificados requieren reglas de exclusión. La pregunta práctica es quién autoriza el paso de una experiencia a un parámetro persistente.
5. La evaluación debe ser longitudinal
Una prueba aislada no basta. Las organizaciones tendrían que comparar el modelo antes y después de cada ciclo: exactitud, seguridad, coste, latencia, cobertura de casos raros y comportamiento ante información antigua. La métrica clave no es solo cuánto aprendió, sino cuánto cambió sin permiso.
Qué hacer esta semana
- Separar memoria de sesión y memoria persistente. Documenta qué datos pueden vivir solo durante una interacción y cuáles podrían alimentar una actualización posterior.
- Crear una batería de regresión. Incluye casos de negocio frecuentes, casos límite y preguntas que el modelo resolvía bien antes de cualquier ajuste.
- Definir una puerta de consolidación. Exige revisión humana o aprobación de un responsable para que nueva información se convierta en comportamiento persistente.
- Medir la reversibilidad. Cada ciclo debe dejar una versión, un registro de entradas utilizadas y un procedimiento para volver al estado anterior.
- Probar con datos sintéticos antes de tocar producción. El “dreaming” puede ser útil como método de entrenamiento, pero los ejemplos generados también pueden amplificar errores del modelo.
Qué todavía no sabemos
La publicación de Google Research no demuestra que el enfoque elimine el olvido catastrófico en todos los dominios ni que sus resultados se trasladen sin cambios a modelos comerciales, sistemas multimodales o flujos con datos sensibles. Tampoco presenta una receta de despliegue para una empresa concreta.
Hay preguntas abiertas: ¿cuánto cuesta cada ciclo frente a recuperar información con herramientas externas? ¿Cómo se detecta una consolidación incorrecta antes de que llegue a usuarios? ¿Qué garantías ofrecen los bloques de expertos cuando cambian los datos? ¿Cómo se separa una mejora genuina de una adaptación excesiva al conjunto de evaluación?
La señal importante no es que los modelos vayan a dormir. Es que el diseño de sistemas de IA empieza a considerar explícitamente el tiempo: interacción, pausa, memoria, evaluación y reversión.
Una línea de continuidad en Olbrite
Este enfoque conversa con dos piezas recientes del blog:
- La IA no solo lee materiales: empieza a conectar sus átomos con sus propiedades, porque ambos trabajos usan modelos para convertir representaciones complejas en capacidades útiles sin confundir predicción con validación.
- Cuando la IA científica enseña sus fuentes, el descubrimiento deja de ser una caja negra, una continuidad directa para la exigencia de trazabilidad: si un modelo incorpora algo, la organización debe poder explicar de dónde salió y qué cambió.
- Europa convierte la calidad de la IA en un proceso auditable: qué cambia con EN 18286, relevante porque una memoria persistente introduce un nuevo punto de control dentro del ciclo de vida del sistema.
El modelo que aprende también necesita un momento de revisión
La mejor lectura del marco de Google no es que la IA haya encontrado una versión digital del sueño humano. Es más sobria: aprender continuamente exige diseñar cuándo el sistema actúa, cuándo procesa lo ocurrido y quién decide qué merece quedarse.
Si esa pausa se convierte en una caja negra, solo habremos automatizado el olvido. Si queda rodeada de pruebas, versiones y autoridad clara, puede ser una pieza útil para pasar de modelos estáticos a sistemas que evolucionan sin perder el control.
Fuentes consultadas
- Google Research: The sleep framework: A new way for LLMs to retain knowledge in continual learning — 27 de octubre de 2026.
- arXiv: Language Models Need Sleep: Learning to Self-Modify and Consolidate Memories — versión 2, 10 de julio de 2026.
- Google Research: The latest research from Google — registro de publicación y fecha.