La reproducibilidad de una IA puede romperse antes de que empiece a aprender
Una investigación de la Universidad de Sídney identifica una geometría fractal que puede empujar entrenamientos casi idénticos hacia soluciones distintas. Para las empresas, la lección no es abandonar la IA: es dejar de llamar «reproducible» a un único resultado.
Repetir un entrenamiento suele parecer una tarea mecánica: mismos datos, misma arquitectura, misma configuración y, en teoría, el mismo modelo al final. La práctica lleva tiempo mostrando que no siempre ocurre así. Una semilla aleatoria, el orden de los lotes o una diferencia minúscula en la ejecución pueden cambiar el resultado.
Un estudio publicado el 5 de noviembre en Nature Machine Intelligence propone que, en determinados sistemas de aprendizaje profundo, la explicación puede ser más profunda que un fallo de ingeniería. Andrew Ly y Pulin Gong, de la Universidad de Sídney, describen una estructura matemática que hace que soluciones diferentes permanezcan entrelazadas incluso cuando se examinan con una precisión extrema.
El hallazgo importa fuera del laboratorio. Si una empresa evalúa un modelo a partir de una sola corrida, puede estar midiendo una trayectoria afortunada —o desafortunada— y no el comportamiento típico del sistema.
El hallazgo: un mapa de entrenamiento lleno de fronteras
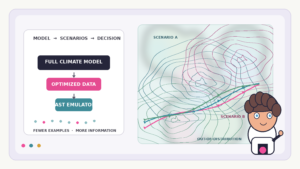
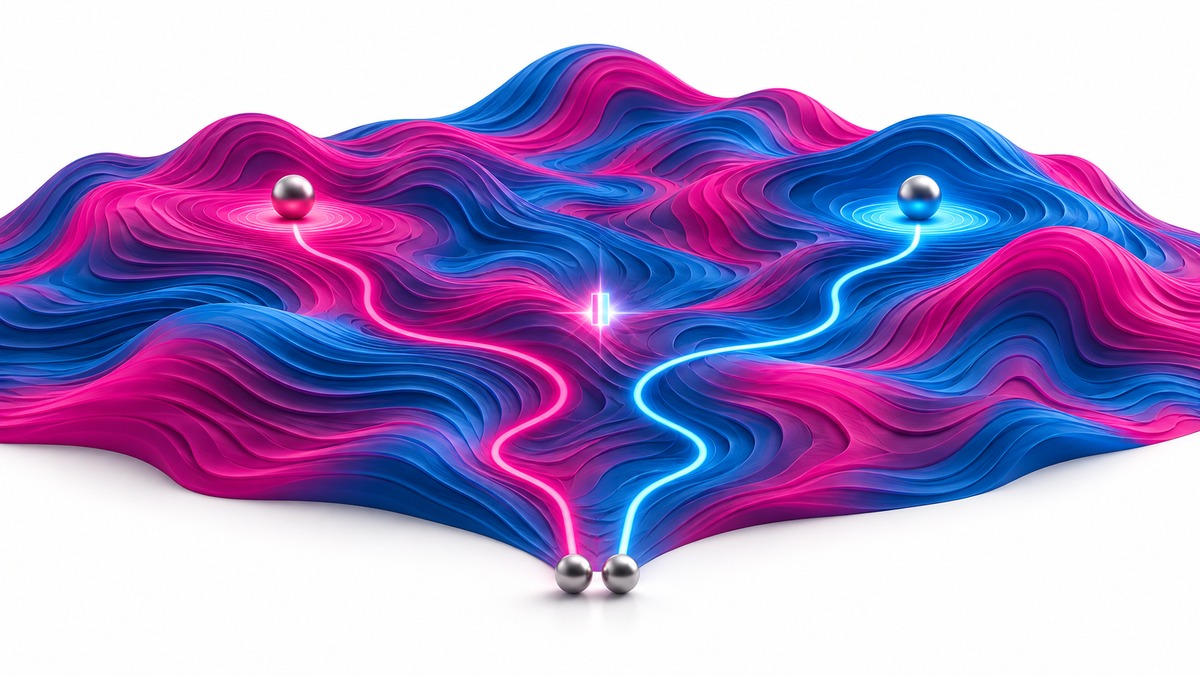
Los investigadores llaman a esta estructura «riddled basin geometry», que puede traducirse como geometría de cuencas de atracción entrelazadas. La idea se entiende mejor con un mapa: cada punto de partida representa una configuración inicial de la red y cada región del mapa conduce a un resultado final diferente.
En un escenario sencillo, bastaría con alejarse de la frontera entre dos regiones para que el resultado fuera más predecible. Pero una cuenca «riddled» tiene una geometría fractal: puntos que llevan a otra solución aparecen dentro de cualquier escala que se observe. Afinar la posición inicial ayuda poco porque la frontera no desaparece al ampliar el mapa.
El artículo distingue así entre una sensibilidad que podría reducirse con mejores controles y una incertidumbre que persiste a escalas muy pequeñas. No afirma que todos los modelos sean impredecibles ni que la ingeniería de reproducibilidad carezca de valor. Propone un mecanismo para explicar por qué, incluso después de controlar fuentes conocidas de aleatoriedad, ciertos entrenamientos siguen pudiendo divergir.
Qué midieron los investigadores
El trabajo combina un modelo mínimo, análisis matemático y experimentos con redes más profundas. Entre sus señales principales están estas:
- El equipo analizó aproximadamente 500.000 redes neuronales en sistemas relacionados con reconocimiento de imágenes y procesamiento de texto, con distintas arquitecturas, conjuntos de datos y procedimientos de entrenamiento.
- En una red de reconocimiento de imágenes, hacer que la configuración inicial fuera 10.000 millones de veces más precisa no produjo una mejora medible en la reproducibilidad.
- Cambiar el bit más pequeño que el ordenador podía representar en una condición inicial llevó a otra configuración interna en cerca del 48 % de los casos de ese experimento.
- El artículo también estudió la reproducibilidad de la función aprendida —lo que el modelo hace con sus entradas— y no solo la de sus parámetros. En el diagnóstico descrito, la diferencia funcional se estabilizó alrededor del 2,9 %, mientras el exponente de incertidumbre funcional fue indistinguible de cero dentro del margen reportado.
El dato del 48 % necesita contexto. No significa que casi la mitad de las respuestas de un chatbot vayan a cambiar por un bit, ni que una pequeña variación vuelva inútil cualquier sistema de IA. Significa que, en una red y bajo las condiciones examinadas, una perturbación mínima pudo llevar el entrenamiento a otra configuración interna con una frecuencia cercana a la mitad. Los resultados de un laboratorio no deben convertirse en una regla universal para todos los productos.
La investigación encontró señales compatibles con esta estructura incluso en entornos deterministas. Eso desplaza la conversación: fijar semillas, congelar el orden de los datos y controlar el hardware sigue siendo necesario, pero no garantiza por sí solo que dos entrenamientos lleguen al mismo destino.
La tensión que las empresas no pueden esconder
El estudio identifica además un intercambio incómodo entre rendimiento y repetibilidad. Las configuraciones que permitían aprender con más eficacia tendían a ser más difíciles de predecir y reproducir. Reducir la tasa de aprendizaje podía hacer los resultados más consistentes, pero también podía reducir la capacidad de aprendizaje observada en los experimentos.
No hay aquí un botón de «hacer confiable» que funcione sin coste. Una organización puede priorizar estabilidad, capacidad, velocidad o consumo, pero debe saber qué está sacrificando. Presentar el mejor resultado de una única corrida como si fuera una propiedad garantizada del modelo oculta precisamente esa decisión.
La lectura de Olbrite: una semilla fija no es una garantía
Para un equipo de negocio, el cambio de perspectiva es concreto: la reproducibilidad debe tratarse como una propiedad que se mide en una distribución de ejecuciones, no como una casilla que se marca al fijar un número de semilla.
- Operaciones: un modelo que cambia de comportamiento entre entrenamientos puede alterar umbrales, prioridades o clasificaciones en procesos repetidos. El equipo necesita saber cuánto varía el resultado antes de automatizar una decisión.
- Personas: si los analistas deben descubrir por ensayo qué versión del entrenamiento produjo la respuesta fiable, la carga de verificación se vuelve un coste oculto y la confianza se erosiona.
- Producto: una demo construida sobre la mejor corrida puede prometer una consistencia que el sistema no ofrece. La interfaz y la documentación deben separar rendimiento máximo de rendimiento esperado.
- Riesgo: en salud, finanzas, cumplimiento o seguridad, una variación pequeña puede ser más relevante que una mejora media en el benchmark. El control debe mirar los casos extremos y no solo el promedio.
- Costes: repetir entrenamientos, comparar ejecuciones y conservar artefactos consume tiempo y cómputo. Ese presupuesto forma parte del coste real de poner la IA en producción.
- Ventaja competitiva: las empresas que conocen la variabilidad pueden decidir dónde usar un modelo, cuándo combinar varias ejecuciones y cuándo exigir revisión humana. Las que no la miden confunden una cifra puntual con capacidad estable.
La tesis es simple: la confianza no nace de que una corrida salga bien, sino de saber cómo se comporta el sistema cuando se repite.
Qué hacer esta semana
- Definir una prueba de repetibilidad antes del siguiente entrenamiento. Repetir la misma configuración varias veces y registrar la dispersión de métricas, no solo la mejor puntuación.
- Guardar el contexto completo de cada corrida. Versionar datos, código, pesos iniciales, semilla, orden de lotes, hiperparámetros, librerías, drivers, hardware y cualquier transformación aplicada.
- Comparar el modelo, no solo sus pesos. Dos redes pueden tener parámetros distintos y comportarse de forma parecida; por eso conviene medir también predicciones, errores y decisiones sobre un conjunto fijo.
- Separar el entorno determinista del entorno real. Una prueba con operaciones deterministas ayuda a aislar causas, pero otra con la infraestructura de producción muestra la variabilidad que el negocio realmente tendrá.
- Fijar umbrales de decisión. Si la variación entre corridas cruza un límite relevante para el proceso, detener el despliegue, repetir la evaluación o introducir una revisión humana.
Qué conviene observar ahora
La investigación abre una línea de trabajo, no la cierra. Habrá que comprobar cómo se comportan estas señales en más arquitecturas, tareas y escalas; qué cambios reducen la geometría inestable sin destruir el rendimiento; y cómo traducir los exponentes de incertidumbre a controles que un equipo de producto pueda operar.
También conviene mantener una distinción: el estudio analiza principalmente la variabilidad del entrenamiento. No demuestra que un sistema de recuperación documental, un agente o un asistente vaya a producir respuestas diferentes en cada consulta. Esos productos tienen otras fuentes de variación y necesitan sus propias pruebas. Lo que sí deja claro es que la frase «hemos fijado la semilla» no basta como evidencia completa de reproducibilidad.
Este hallazgo prolonga dos conversaciones que Olbrite ya había puesto sobre la mesa. La IA ya no puede ser una caja negra cuando ocurre un incidente explica por qué una organización necesita reconstruir lo que pasó; la IA puede saber mucho y aun así no saber cuándo callar muestra que la capacidad también incluye reconocer límites. La reproducibilidad añade otra pregunta: ¿podemos obtener de nuevo el comportamiento que estamos a punto de confiarle a una operación?
Una IA empresarial no tiene que producir siempre el mismo número para ser útil. Pero una empresa sí tiene que saber qué puede cambiar, con qué frecuencia y qué hará cuando cambie. La reproducibilidad no es una promesa estética del laboratorio: es una condición de gobierno.
Fuentes consultadas
- Ly y Gong, «Fractal basin geometry and the limits to predictability and reproducibility in deep learning», Nature Machine Intelligence, 5 de noviembre de 2026.
- Universidad de Sídney, «Sydney researchers uncover a hidden limit to AI predictability», 6 de noviembre de 2026.
- Prepublicación y materiales del estudio en arXiv.