Durante los últimos dos años, la estrategia de globalización e internacionalización de la mayoría de las corporaciones cayó en una trampa de costes inadvertida pero asfixiante: el “impuesto generalista” de la inteligencia artificial. Para traducir contratos confidenciales, catálogos de e-commerce con millones de referencias o conversaciones de soporte en tiempo real, los equipos de tecnología comenzaron a enrutar peticiones a modelos de frontera masivos como GPT-6 Astra, Claude o Gemini Pro. El resultado fue pagar tarifas astronómicas de razonamiento cognitivo por lo que en esencia es una tarea de transferencia lingüística y coherencia terminológica.
Ese paradigma acaba de recibir un golpe de gracia. El 10 de septiembre de 2026, Cohere y Cohere Labs anunciaron el lanzamiento oficial de North Small Translate, el primer modelo de su nueva familia North diseñado con un objetivo singular: resolver la traducción automática empresarial de alta precisión sin arrastrar la sobrecarga computacional de un LLM generalista. Los resultados no solo superan los estándares de la industria, sino que alteran de raíz la economía operativa de la localización corporativa.
Los números sobre la mesa: 83,6 en WMT26 y un 98% menos de coste
En el terreno de la traducción automática, los benchmarks independientes son implacables. Según las evaluaciones en el estándar WMT26 a lo largo de más de 50 idiomas, North Small Translate alcanzó una puntuación global de 83,6, superando con holgura a los dos referentes históricos del mercado corporativo: DeepL NextGen (81,2) y la infraestructura tradicional de Google Translate (68,0). En idiomas de altos recursos, el modelo escala hasta los 87,6 puntos, demostrando una fidelidad léxica y gramatical idéntica a la revisión humana profesional.
Sin embargo, la verdadera brecha cualitativa se encuentra en los mercados emergentes. En regiones de alta fricción lingüística como el sur de Asia y MENA (Oriente Medio y Norte de África), donde las soluciones propietarias occidentales suelen degradarse rápidamente, North Small Translate registra una ventaja de entre 9 y 10 puntos por encima de DeepL. Para multinacionales con operaciones en el Golfo, India o el sudeste asiático, esta diferencia representa la eliminación de barreras operativas históricas.
Pero el dato que está capturando la atención de directores de tecnología y finanzas es el coste por inferencia. En un desglose de tareas promedio de 661 tokens, Cohere documentó un coste de 0,000676 dólares por tarea. En comparación, procesar esa misma carga de trabajo a través de modelos como Gemini 3.1 Pro Preview alcanza los 0,038928 dólares: una diferencia de más de 58 veces (un 5.700% más costoso). El mensaje para las empresas es inequívoco: seguir utilizando modelos de razonamiento general para tareas de traducción es un despilfarro financiero insostenible.
Arquitectura MoE: 218B de capacidad con la ligereza de 25B activos
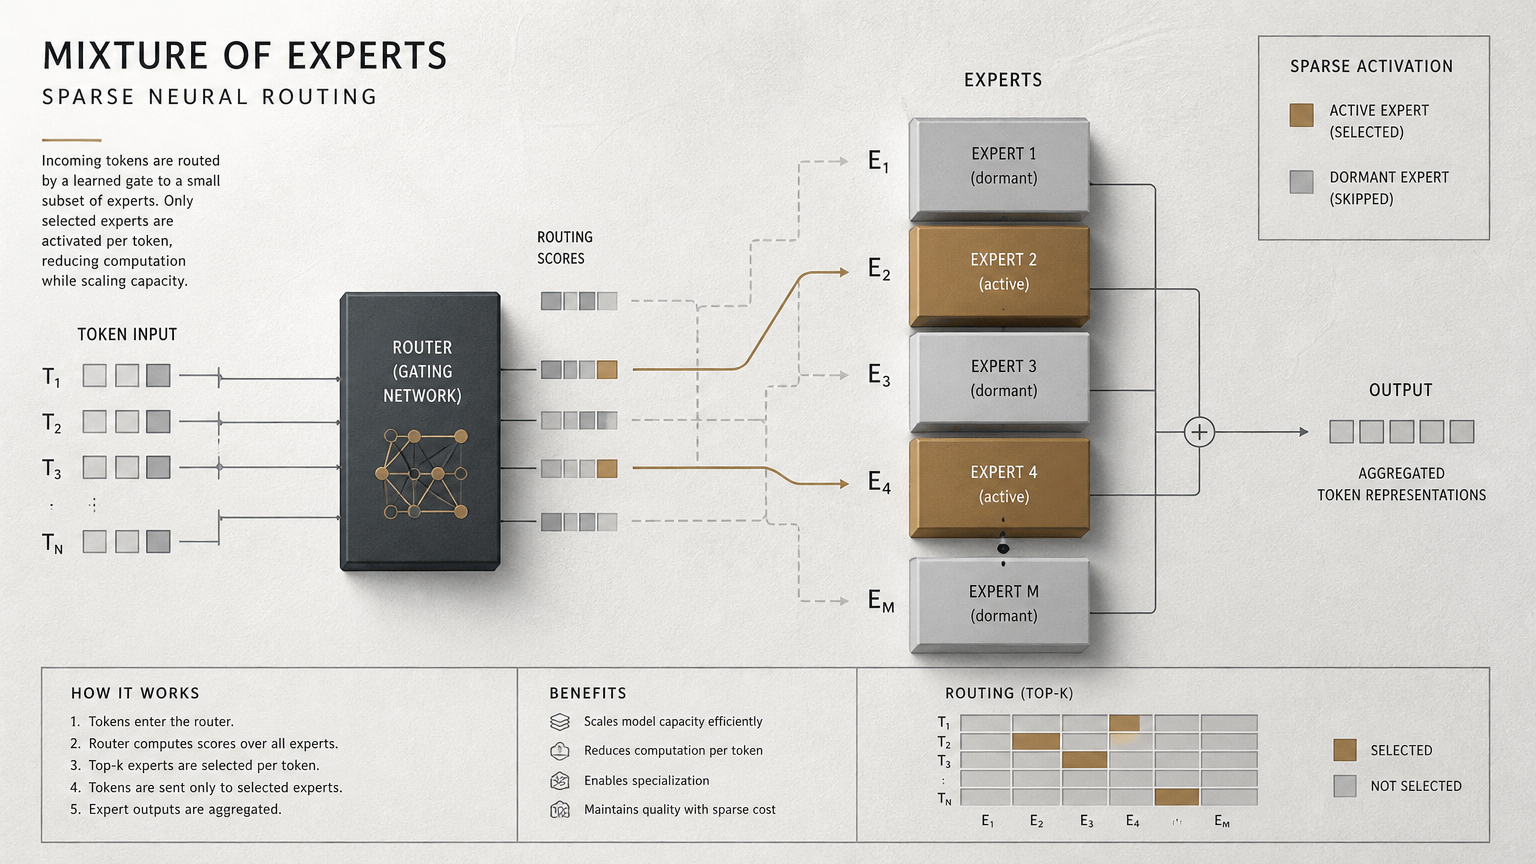
La clave técnica detrás de este salto de rendimiento radica en su diseño Mixture-of-Experts (MoE) disperso. North Small Translate cuenta con 218.000 millones de parámetros totales, pero su mecanismo de enrutamiento solo activa 25.000 millones de parámetros por cada token procesado. El modelo integra 128 expertos especializados, de los cuales un enrutador inteligente activa únicamente los 8 más pertinentes para el contexto idiomático y sectorial específico, combinados con expertos compartidos que se ejecutan de manera constante para garantizar coherencia global.
A nivel de atención, el equipo de investigación adoptó la arquitectura híbrida introducida originalmente en Command A: una combinación en proporción 3:1 de capas de atención de ventana deslizante (sliding-window attention de 4.096 tokens con RoPE) y capas de atención global. Esta disposición permite gestionar una ventana de contexto simétrica de 16.000 tokens de entrada y 16.000 tokens de salida, suficiente para procesar contratos mercantiles íntegros, auditorías fiscales o manuales de ingeniería complejos en un único pase de inferencia sin truncamiento de información.
Este avance refleja una tendencia de fondo que en Olbrite hemos venido analizando: tal como observamos con la liberación de Tencent Hy4 y las arquitecturas abiertas de 770B, la eficiencia del cómputo corporativo ya no depende de inflar modelos monolíticos densos, sino de dominar el enrutamiento dinámico de parámetros especializados.
“El valor en la IA corporativa moderna no está en tener un modelo gigante que haga todo de forma mediocre y costosa, sino en desplegar micro-arquitecturas de alta precisión cuyo coste marginal tienda a cero.”
Soberanía de datos y despliegue privado: Adiós a la fuga de información
Más allá de las métricas de precisión y coste, el factor decisivo para su adopción en empresas reguladas es la soberanía operativa. A diferencia de soluciones cerradas tipo caja negra que exigen transmitir datos corporativos sensibles a servidores externos, Cohere ha publicado los pesos de North Small Translate bajo una licencia de investigación en Hugging Face (CC BY-NC 4.0), complementada por acuerdos de licenciamiento comercial corporativo mediante la plataforma Language Weaver de RWS.
En términos de infraestructura física, el modelo está optimizado para ejecutarse en entornos locales o nubes privadas cerradas: requiere únicamente una GPU NVIDIA B200 en cuantización W4A4 o un nodo de dos NVIDIA H100 a W4A4. Para firmas legales, entidades bancarias y organizaciones sanitarias sujetas a normativas estrictas como GDPR, HIPAA o la Ley Europea de IA, esto representa la posibilidad de traducir litigios, historiales médicos y reportes financieros sin que un solo byte abandone el perímetro seguro de la organización.
Esta decisión se alinea directamente con la necesidad de garantizar una supervisión técnica real, un principio que abordamos al discutir por qué la gobernanza en papel es inútil si la seguridad de la IA no se ejecuta en el propio endpoint. Asimismo, refuerza el cambio cultural detectado en nuestro informe donde el 32% de las empresas frena compras de SaaS para desplegar capacidades de software internas respaldadas por agentes y modelos abiertos.
4 Casos de uso de alto impacto operativo
Para los líderes de negocio y directores de operaciones, North Small Translate desbloquea cuatro frentes inmediatos de rentabilidad y eficiencia:
- 1. Localización omnicanal de soporte al cliente: Integración directa en sistemas de tickets y chats de atención. En lugar de retrasar respuestas o depender de traductores externos para idiomas con baja cobertura, los agentes humanos o virtuales pueden interactuar en más de 50 idiomas con latencia imperceptible y fidelidad técnica garantizada.
- 2. M&A y Due Diligence transfronterizo: Análisis y traducción instantánea de salas de datos virtuales con miles de folios notariales, patentes y balances contables en adquisiciones internacionales, garantizando confidencialidad absoluta y ahorrando semanas de honorarios de traducción jurada preliminar.
- 3. Catálogos globales de comercio electrónico: Localización dinámica de descripciones de producto, fichas técnicas y opiniones de usuarios para millones de SKUs. A un coste de menos de una milésima de dólar por ficha, los minoristas globales pueden expandirse a nuevos mercados sin incurrir en costes prohibitivos.
- 4. Subrutinas especializadas para arquitecturas multi-agente: En sistemas agénticos complejos, delegar la capa de traducción a un micro-modelo especializado evita consumir la valiosa ventana de contexto y los costosos tokens de razonamiento del modelo orquestador principal, un concepto esencial dentro de la economía de modelos y el régimen escalonado de inferencia.
La lección estratégica: Especialización vs. Monolitos
La llegada de North Small Translate confirma una premisa que definirá la maduración de la inteligencia artificial corporativa en los próximos años: la época dorada de intentar resolver cada flujo de trabajo empresarial con un único modelo gigantesco y generalista ha terminado. Los monopolios basados en cobrar peajes elevados por servicios lingüísticos básicos están perdiendo su foso defensivo ante la irrupción de modelos abiertos especializados de arquitectura MoE.
Aquellas organizaciones que auditen hoy sus arquitecturas de software para desacoplar las tareas puramente lingüísticas del razonamiento cognitivo no solo protegerán su balance financiero: ganarán la agilidad y la soberanía necesarias para operar a escala global sin depender de los peajes de ningún gigante tecnológico.
Artículos recomendados sobre estrategia y arquitectura de IA:
- El 32% de las empresas frena compras de software para construirlo con agentes de IA: la gran paradoja del ‘Build vs. Buy’ en 2026
- Anthropic, Google y OpenAI dividen la IA en dos regímenes: qué cambia para las empresas cuando la frontera exige verificación
- Tencent libera Hy4 preview con 770B parámetros y licencia Apache 2.0: qué cambia para la autonomía y el cómputo empresarial
- Por qué la gobernanza en papel no frena a un agente en ejecución: la seguridad de la IA se muda al endpoint con AIDR